公众号文章批量采集API接口 支持历史内容回溯
做新媒体数据运营的团队,几乎都遇到过同一个痛点:想要整理竞品账号过往3年的所有内容做内容策略分析,手动翻页复制不仅要花上几周时间,还很容易漏掉关键的爆款数据,最后整理出来的表格错漏百出,根本没法支撑后续的决策。这篇文章就给你讲清楚,如何通过公众号文章批量采集API接口,高效完成全量历史内容的回溯与结构化整理,解决新媒体数据运营的核心效率难题。
公众号历史内容回溯的核心行业痛点
很多运营者在选择公众号文章批量采集工具时,很容易踩进几个常见的坑:要么是工具只能采集最近7天的公开内容,超过时间范围的历史文章完全无法获取;要么是调用频率被严格限制,一天最多只能采集几十篇内容,遇到账号内容量大的情况,根本没法在短时间内完成任务;还有的工具返回的数据格式混乱,互动数据和正文内容分开存储,后续还要花大量时间做数据清洗,反而增加了额外的工作量。这些问题的本质,是没有选到真正支持历史内容回溯、数据返回完整的合规API接口。很多运营团队在做全量内容数据整理时,往往还需要同步获取直播间的实时互动数据做交叉分析,可借助视频号直播实时数据监测工具完成多维度数据打通
合规API接口的3项核心能力标准
一套合格的公众号文章批量采集API接口,首先要满足历史内容回溯的核心能力:支持指定时间区间内的全量文章拉取,哪怕是账号2018年发布的历史内容,也能通过接口直接返回结构化数据,不需要手动翻页查找。其次,接口的调用机制要足够灵活,不需要严格限制每日调用次数,运营团队可以根据自己的项目进度,自主调整采集节奏,不用为了赶进度熬夜排队调用接口。更重要的是,接口返回的所有字段都要保持统一格式,文章标题、发布时间、正文内容、阅读量、在看数、点赞数、评论数、分享数等核心字段一次性同步返回,不需要额外对接多个不同的接口才能拿到完整数据。沉淀完全的历史内容资产后,搭配多账号统一管理能力,能进一步提升矩阵运营效率,可通过公众号矩阵多账号免扫码管理系统实现账号侧的高效协同
4小时完成20个账号全量数据采集实操案例
我们接触过的一家杭州本地MCN机构,之前为了整理旗下20个公众号账号的5年历史内容,安排了3名运营人员手动整理,整整花了2周时间,最后整理出来的内容还缺失了近30%的历史爆款数据,根本没法用来做内容复盘。后来他们接入了支持历史内容回溯的公众号文章批量采集API接口,只用了不到4个小时,就把20个账号的所有历史文章全量拉取到本地数据库,自动生成了按发布时间、内容标签、互动数据分类的分析报表,不仅节省了近90%的人工成本,数据准确率也提升到了99%以上。
接口落地使用的3个效率优化细节
在实际使用这类API接口的过程中,有几个细节能大幅提升你的使用效率:第一,在发起采集请求时,优先指定精确的时间区间,不要无限制拉取全平台所有内容,这样既能减少不必要的接口调用消耗,也能让返回的数据更贴合你的项目需求;第二,提前在后台配置好数据同步规则,让接口返回的数据直接同步到你的本地数据库或者BI分析工具里,不需要手动导出Excel再二次导入,避免中间环节出现数据丢失;第三,搭配增量更新机制,第一次完成全量历史内容回溯之后,后续每天只需要调用一次接口拉取当日新发布的文章,不需要重复拉取历史内容,长期运营下来能大幅降低数据维护成本。如果你的业务有特殊的字段采集需求,标准化API无法完全覆盖,也可以选择新媒体数据合规定制采集服务拿到专属数据接口
新媒体数据采集的合规边界说明
很多人会关心这类数据采集的合规性问题,正规的公众号文章批量采集API接口,完全是基于平台公开可访问的内容进行结构化整理,不会涉及任何用户隐私数据,所有采集到的内容都仅用于内部运营分析,完全符合当前的数据安全相关规范,不会给企业带来合规风险。对于新媒体运营团队来说,这类工具的核心价值从来不是“爬取数据”,而是把运营人员从低价值的手动复制粘贴工作中解放出来,把更多精力放在内容策略优化、用户运营这些真正能产生业务增量的环节上。
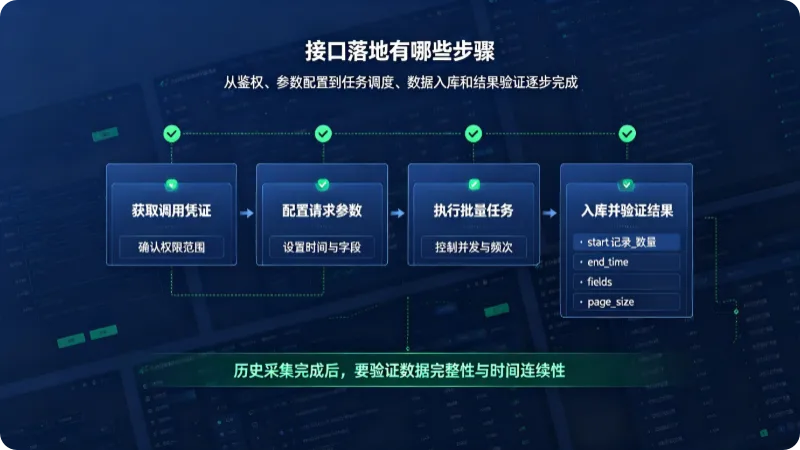
总结来说,支持历史内容回溯的公众号文章批量采集API接口,是新媒体数据运营的核心基础设施之一。它解决了长期以来行业内历史内容整理效率低、数据错漏多的痛点,让团队能快速沉淀全量的内容资产,基于完整的历史数据做出更精准的内容决策。对于任何想要搭建自己的新媒体内容数据库、做长期内容竞品分析的团队来说,这类API接口都是必不可少的工具。