公众号数据采集的三个坑:字段口径、采集频率、历史回采,我挨个踩过
去年秋天接了个活儿,帮一家做母婴用品的品牌做内容月度复盘。要盯的公众号一共 26 个,8 个是竞品,剩下的是行业媒体和他们自己的矩阵号。
一开始想法很简单:找个工具,把数据拉下来,做张表就完事。真动手了才发现,问题不在"能不能采到",而在"采到的数据能不能用"。
坑一:字段看着挺全,但没告诉你这个数是什么时候读的
公众号的阅读量是动态的。同一篇文章,推送当天可能只有八千,一周后跑到三万六。这不是数据错了,是推荐机制和二次传播在起作用。
很多采集工具返回的是"当前值",不标注读取时间。我们第一批数据就是这么废掉的:周一拉的竞品数据和周三拉的自家数据拼在一张表里,同一个账号,同事看了半天,问我是不是哪一步算错了。
后来定了个规矩:所有数据入库必须带采集时间戳,做趋势只看同口径的连续快照。这一条改完,表才算能用。
坑二:采集频率不是越高越好
我一开始把监控频率设成五分钟一轮,觉得数据越密越准。跑了两天就出问题,不是请求超时,就是单次返回条数变少。
后来才明白,平台侧的调用是有约束的。请求得越密,每次能拿到的反而越少,漏采的概率还上去了。
现在的做法是分层:重点竞品按小时采,行业媒体按天采,长尾账号一周补一次。数据够用就行,没必要为了"密"把稳定性搭进去。
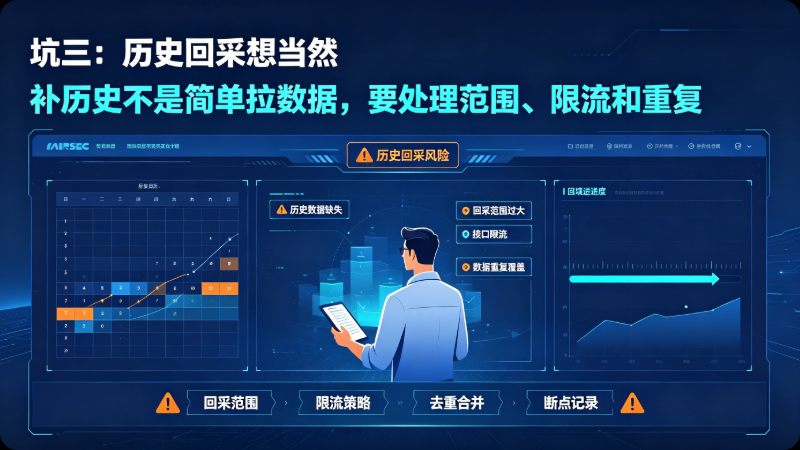
坑三:历史回采,卡点不在数据在链接
做年度复盘要回采过去的文章,最早要追到两年前。这里有两处麻烦。
一是文章列表不好拿全。账号入口、原始 ID、文章链接这三个入口都得试,有些号改过名、主体也变更过,只按名称搜一定漏。
二是链接本身。早期文章的原文链接不少是临时链,过一段时间就打不开。历史回采得先把临时链转成永久链,再做正文补档,不然采回来一堆死链。
后来这块我们怎么处理的
采集交给了极致了数据的接口,选它主要是三个原因:字段口径有文档,阅读、点赞、在看分别取的是哪个时间点的值写得清楚;支持定时拉取,方便配合时间戳做快照;历史回采能往早里拿到文章列表。
如果你也在做多账号采集,建议先做一张自检清单:时间戳有没有、频率是不是过度、历史链接能不能打开、字段定义有没有对齐。这四项过了,数据才谈得上可用。
关于极致了数据
专注全媒体数据 API 服务,覆盖公众号、视频号、抖音、小红书等平台,提供账号数据、
内容数据、评论数据等结构化接口,支持按次计费、失败不扣费、历史数据可回溯。
本文为极致了数据原创内容,转载请注明出处。