公众号历史数据怎么查?除了阅读量,删文记录才是监测盲区
做公众号运营的人,几乎都踩过同一个坑:月底复盘想拉一份年度数据,打开后台才发现,半年前那篇爆文的阅读来源、分享转化早已被清空,只剩下一个孤零零的标题挂在列表里。更别提想看竞品过去三年的增长拐点,或者老板突然问“我们账号在行业里到底排第几”,手上除了自己后台那点有限的数据,什么都拿不出来。
公众号历史数据怎么查,表面上是“找不到入口”的技术问题,实际上是一个分层问题。不同深度的数据,藏在完全不同的地方,用错方法,要么白费力气,要么拿到的数据根本撑不起决策。
第一层:文章内容与基础阅读数据——能看见,但需要“批量拉”
如果你只需要知道一个号发过哪些文章、每篇的标题和大致阅读量,最直接的办法是翻公众号主页。手动下滑能翻到历史消息,每篇文章底部也显示阅读数和在看数——前提是号主没有主动隐藏。
但手动翻几百篇的效率几乎为零。这一层的合理做法是借助批量导出能力。市面上有若干开源工具和浏览器插件可以实现历史文章列表的结构化抓取,导出标题、发布时间、链接和当前可见的阅读数据。它们的共同边界是:拿得到“文章层面”的公开快照,但拿不到传播过程数据,也拿不到粉丝增长曲线。
第二层:账号趋势与行业对比——SaaS平台的主场,但要接受“估算值”
想判断一个号是在涨还是在跌,单看几篇文章的阅读量不够,需要放到行业大盘里比。这一层是新榜、西瓜数据、清博指数这类SaaS数据平台的用武之地。
新榜的优势在于账号收录量大、行业榜单做得早,适合快速摸清一个领域里有哪些头部号、各自大致处于什么位置。西瓜数据在竞品动态追踪和爆款内容分析上更细,覆盖500万+公众号,阅读数监控可以做到分钟级追踪指定文章的传播趋势。清博指数则以WCI传播力指数体系见长,采集节奏是每日两次、T+1更新,在政务和企业品牌监测场景中用得较多。
但这套方案有一个需要提前知道的“代价”:SaaS平台展示的数据,相当一部分是估算值,尤其是粉丝数和阅读趋势。它能告诉你“大概怎么样”,但撑不起尽调级别的精确分析。而且多数平台的导出功能有配额限制,想按自己的维度做交叉分析,界面和格式的限制会让人很难受。
第三层:深度回溯与自动化归档——微信没给的,只能自己“接出来”
真正棘手的是第三层:你想查一个号两年、三年前的单篇阅读增长、发文频率变化,甚至想把这些数据拉进自己的数据库做自定义报表。这一层,微信官方后台给不了,SaaS平台的标准化报表也给不全。
官方数据接口的留存策略是一个硬约束:服务号接口侧仅存储2014年12月1日之后的数据,而运营后台的详细图文分析通常只完整保留最近一年,部分维度甚至缩短到30天。这意味着,查不到的历史数据,本质上不是“查询技巧”的问题,而是“当时有没有存下来”的问题。
在这一层,可行的路径是API接口或可私有部署的归档工具。通过传入公众号标识,接口可以返回历史文章的结构化字段——标题、发布时间、阅读量、在看数、留言数等,JSON格式直接进数据库,不受平台界面维度的限制。部分方案支持检索近5年的历史推文,并生成月度、季度、年度的趋势汇总,直接补上了官方后台最大的短板。
一个真实场景:历史删文,也是历史数据里的“高价值盲区”
财经媒体“博望财经”曾遇到一个很典型的问题:团队长期监测上百个同行业公众号,除了日常阅读数据,历史删文记录也是核心指标——哪些文章被删、什么时候删、标题是什么,往往能反映竞品的内容调整方向和风险规避动作。但原来使用的工具停服后,监测链条直接断了。
后来他们采用极致了数据的公众号历史删文监测方案:一次性导入100个目标账号,系统自动回溯指定时间范围内的已删除文章记录,并整理成标准Excel,包含媒体名称、发布时间、文章标题、删除原因等字段。监测周期按业务节奏定制为双周一次,每次回溯近一个月数据,按次结算,成本可控。这个案例说明的问题很直接:公众号历史数据怎么查,不能只盯着阅读量,删文记录、结构化导出、周期回溯同样是历史数据能力的一部分;而且真正可用的查询,必须能批量、能留存、能直接进入分析流程。
回到那个绕不开的结论
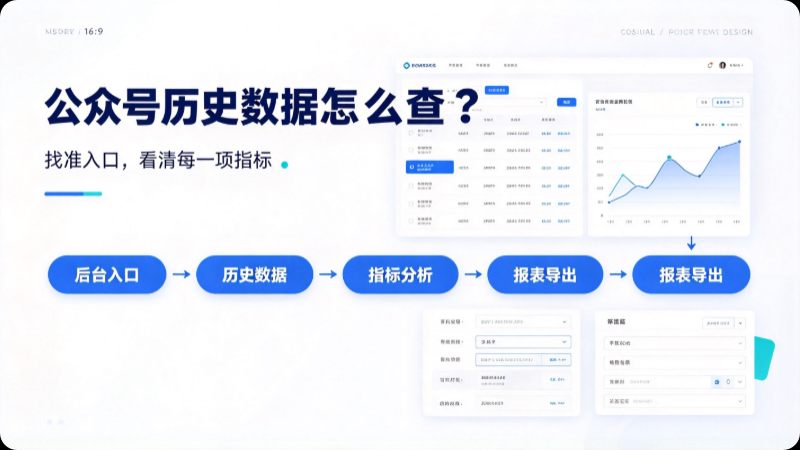
公众号历史数据怎么查,答案取决于你要的是“看一眼”还是“留下来”。看文章翻主页,看趋势上SaaS,要回溯和自动化就老老实实接接口或做归档。
但无论选哪条路,有一个事实不会变:微信后台的“数据保质期”只会越来越短,而你对历史数据的需求只会越来越深。今天觉得“以后再说”的那批数据,三个月后就会变成查不到的那一批。真正有效的查询策略,从来不是等到需要时才去找工具,而是从今天开始,把每一个还在产生数据的日子,变成未来能回溯的资产。