公众号数据采集:真正要盯住的不是阅读量,而是这4组“增量序列”
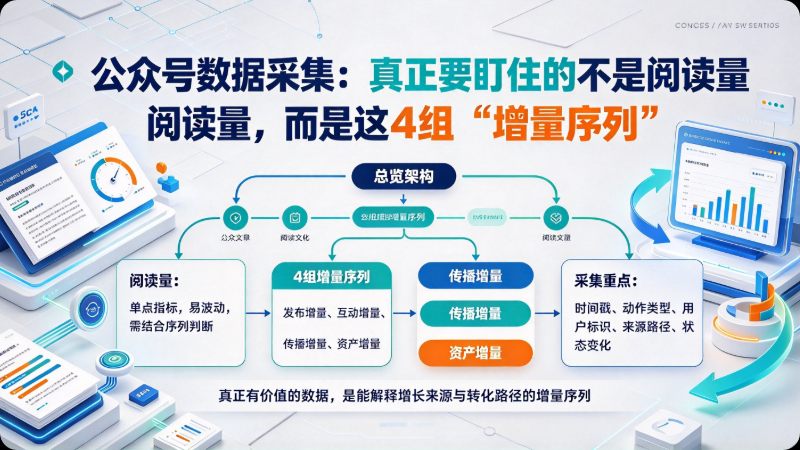
先说结论:公众号数据采集如果只停留在“拉取阅读数、点赞数、在看数”的总量层面,对判断内容表现或识别数据注水的价值极其有限。 总量可以被事后补刷、可以被平台推荐的一次爆发抬高、也可以因为采集时间窗口不同而失去可比性。真正承载判断信息的是增量序列——阅读数在时间轴上的变化形态、互动数据与阅读增量之间的比值波动、以及阅读来源在渠道上的分布结构。采集的精度和维度,直接决定了后续判断是“有据可依”还是“看图说话”。
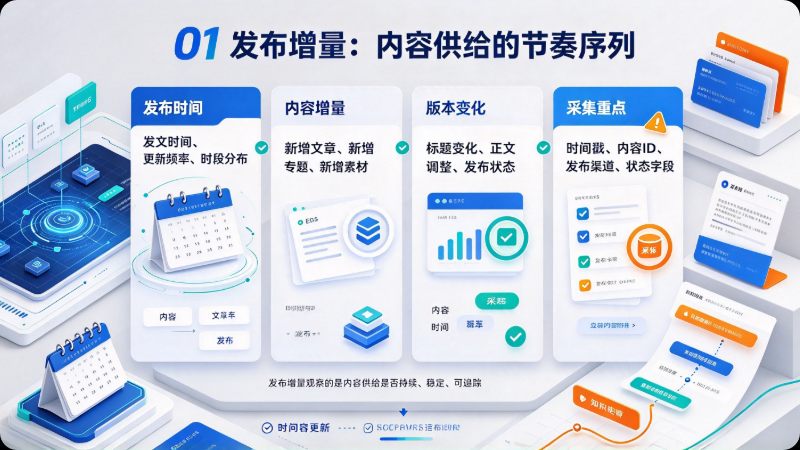
第一组:分钟级阅读增量序列——曲线的“断裂”比数字大小更说明问题
正常文章的阅读增长有一个大致可预期的节奏:发文后前一到两小时完成最终阅读量的大头,随后增速自然衰减,曲线趋于平缓。如果采集的颗粒度停留在“24小时总量”,这条节奏就被压缩成一个数字,断裂、脉冲、隔日补量等痕迹全部丢失。
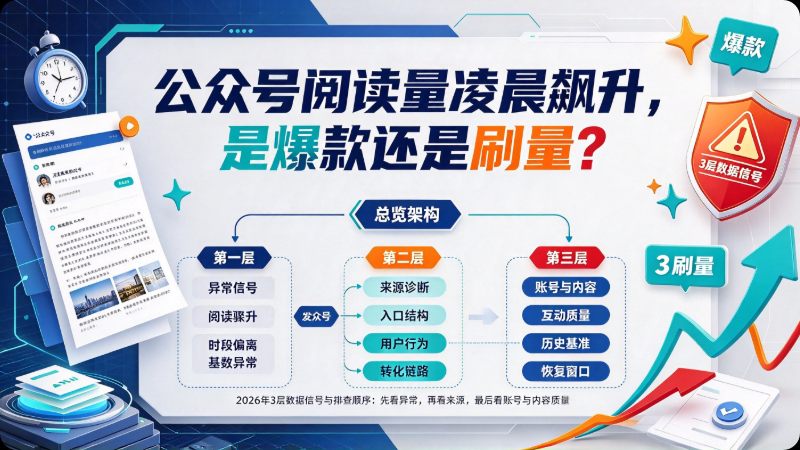
分钟级采集的价值,在于保留曲线形态。需要标记的典型形态包括:脉冲型断崖(平稳上升或自然衰减中突然出现与前后斜率完全脱节的陡增,随后迅速回落或沿原轨迹运行)、凌晨时段飙升(白天推文,阅读增量集中在凌晨0—6点,与真人阅读时间分布无法调和,除非受众主体位于其他时区)、隔日补量(发文当天曲线正常,第二或第三天的日增量与第一天的衰减趋势严重不匹配),以及过于顺滑的曲线(整条线没有任何自然起伏,斜率始终如一)。这些形态单独出现时可能有自然解释,但组合出现时,判断的优先级需要从“内容表现”切换到“数据真实性复核”。
采集频率的选择直接影响形态的可见度:10分钟档可能错过脉冲的起点,1—2分钟档才能完整呈现断崖形态。但这不意味着所有账号都需要上最高频率。分钟级数据最有价值的区间是发文后前2—3小时,后续可以降频或切换到定时汇总。
第二组:互动比值的历史偏离度——不要和行业均值比,和该号自己的基线比
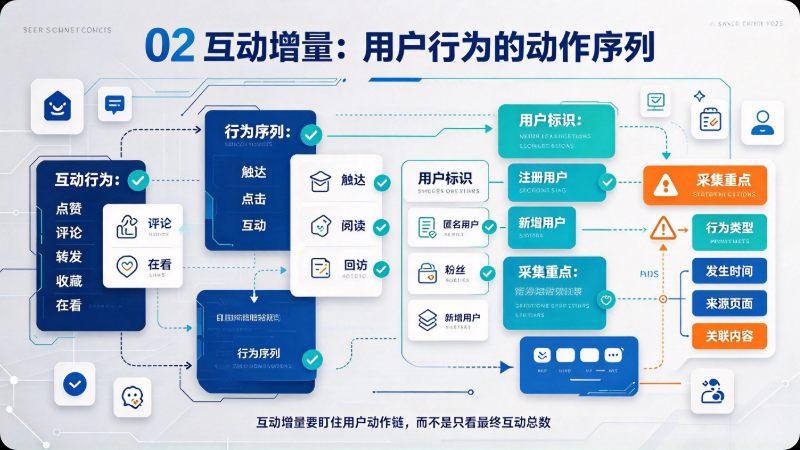
采集互动数据时,一个常见的错误是把“阅读:点赞 = 1000:1.5 到 1000:2”当作判定刷量的硬阈值。这个区间可以作为量级参照,但真正有判别力的是某篇文章的互动比值是否显著偏离该账号自身的历史分布。
一个垂直小号的正常互动比值可能远高于泛娱乐大号,用统一阈值会大量误判。工具层面的判定逻辑是:先建立该账号近30天多篇文章的互动比值基线,再看当前文章的比值是否落在历史分布的极端尾部,或者互动数是否异常稳定、缺乏正常波动。另一个可采集的辅助维度是留言率:正常账号的留言率安全区大致在0.5%—5%,超过8%开始进入需要复核的区间,超过15%则基本可以判定为异常互动。留言本身的内容集中度、时间分布和获赞结构,也是总量采集无法覆盖、但增量采集可以保留的维度。
刷量者可以按比例配送点赞和在看,让比值“看起来合理”,但很难复制真实读者在不同文章之间自然起伏的互动率。“过于配合”的比值稳定,本身就是信号。
第三组:阅读来源的渠道分布——增量落在“会话”还是“转发/推荐”,性质完全不同
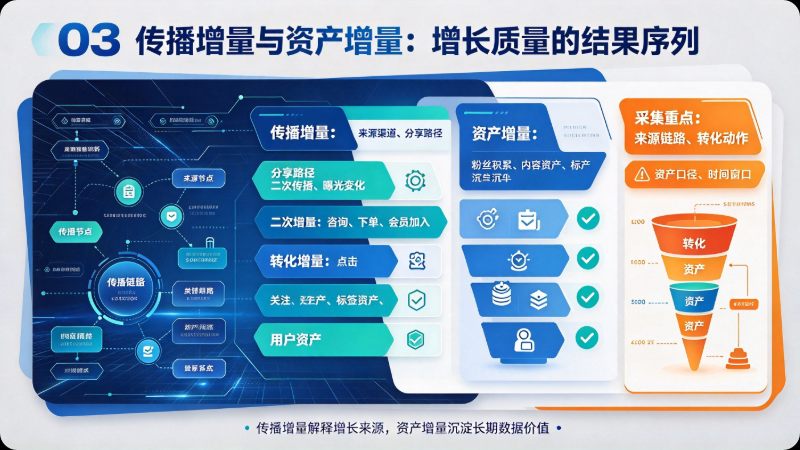
采集阅读来源时,总量采集通常只返回一个“公众号会话”的占比数字,而增量采集可以保留不同渠道在时间轴上的联动关系。
自然传播中,阅读增长往往伴随至少一个外部渠道的同步变化:朋友圈转发、搜一搜、看一看或外部转载,会在“公众号会话”之外留下可追踪的增量分布。刷量带来的阅读则高度集中在“公众号会话”单一入口,且缺乏跨平台的二次传播痕迹。如果一篇凌晨飙升的文章,增量几乎全部沉淀在会话渠道,而转发、推荐、搜一搜没有任何同步抬升,这条数据链的断裂就是判断注水的关键证据。
渠道分布采集的难点在于颗粒度。如果工具只能给出“会话占比”的最终快照,而无法还原增量到达各渠道的时间顺序,那么“会话占比高”这个事实本身并不能直接等同于刷量——平台推荐也可能在短期内将流量集中导入。可采集的时间序列才能区分“集中导入后自然扩散”和“集中导入后没有下文”。
第四组:留存与跳出结构——有动作、无后果的流量最难伪装
灰色流量的一种常见形态是“互阅群”:真人确实点开了文章,停留、点赞甚至慢阅到底,但这些人不是读者,是交易对手。这类流量的特征是阅读量在短时间内从极低水平跳到几十上百,停止互阅后增量立刻归零,后续没有任何自然扩散。
单看后台的阅读数字,这类流量几乎无法识别。需要把留存数据纳入采集范围:正常阅读的前3秒跳出率通常在40%—60%之间;如果一篇内容的平均阅读时长异常高,而跳出率异常低,数据的真实性就值得怀疑。更上游的形态还包括AI抓取和自动化分发带来的“阅读”,它们同样计入后台数据,但不产生搜索、复访或品牌记忆,留存曲线和跳出率是区分这类流量与真实读者参与的主要切口。
采集本身的合规边界:技术可行不等于场景可行
讨论“采集什么”之前,必须先确认采集行为本身处在什么位置。2025年深圳中院的一个判例已经把红线划得比较清楚:被告用爬虫抓取公众号文章数据(含阅读数、点赞数),搭建搜索和排行网站并通过广告变现,法院判赔60万元。判决逻辑可以拆成三层——平台对整体数据资源享有竞争性权益;绕开IP限制、封禁机制和反自动化脚本本身构成妨碍平台正常运行;产品功能实质性替代了平台自身服务。
落到实操上,三条底线可以压缩成一句话:只采集公开可见的数据,不绕过技术保护措施,采集结果的使用场景决定风险等级。 个人学习或内部研究,不走商业化、不替代平台功能,风险相对可控;团队内部长期分析,需要在开源方案基础上做好数据使用管控,确保数据仅限内部使用、不对外分发;商业化产品唯一稳妥的路径是官方API或合规数据服务商。采集本身与“利用自动化替代真人完成内容创作、发布”是两件事,但在设计工作流时应避免让自动化越界到发布环节。
数据口径说明:本文引用的曲线形态分类、互动比值参照区间、留存阈值及合规判例逻辑,来自本平台对公开样本的持续监测与站内方法论文档的整理,适用于量级判断和排查排序,不构成对单个账号的确定性诊断或法律意见。建议以你账号自身近30天的分时增量中位数作为主基线,行业参照值仅作辅助。分钟级采集的频率选择与推送配置,可参见站内《公众号发文分钟级监控怎么做?》中的路径对比;刷量形态的完整分类框架,可回到《公众号刷量识别完整指南》中的三层信号体系。