API 还是飞书插件?公众号数据采集的两条路,选错成本比想象中高
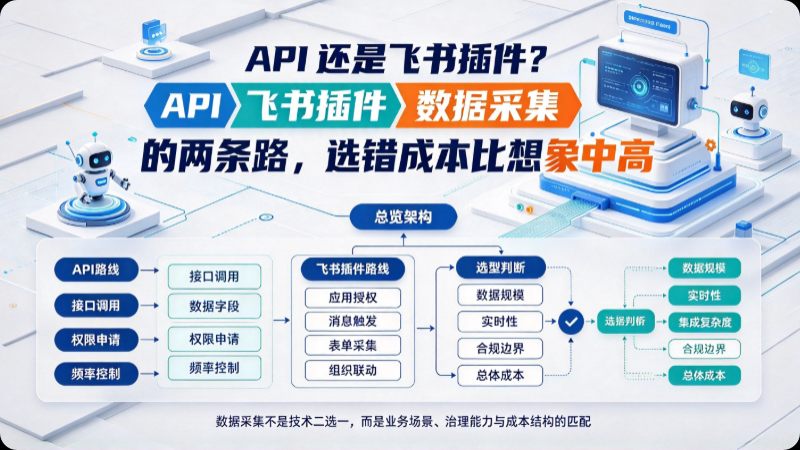
公众号数据采集这件事,表面上是“把数据拿下来”,实际上藏着一个容易被低估的决策:用什么方式拿。g.jzl.com 上大量实战文章反复指向同一个判断——API 接口和飞书插件并不是谁替代谁的关系,它们的真正分界线不在于“先不先进”,而在于数据最终要去哪里、由谁来用、用多大频率用。选错了,技术团队白写一堆对接代码,运营人员对着 JSON 字段干瞪眼;选对了,数据才会在正确的人手里变成可用的资产。
API 接口的底牌:把数据变成“可以流动的结构”
API 采集的核心价值,可以用一句话概括:它产出的不是一张表格,而是一股可以直接进入业务系统的数据流。通过标准化的 REST 接口,调用方传入公众号标识、时间范围和需要返回的字段,服务器直接返回 JSON 结构的结果,阅读数、点赞数、在看数、发文列表、是否原创、是否删除等字段一次性落库。这意味着数据从进入系统的那一刻起就是结构化的、可计算的、可被下游程序直接消费的。
这种形态带来的第一个优势是规模与自动化。当一个团队需要同时监控二十个甚至上百个公众号时,人工逐号打开后台、截图、粘贴的路径会迅速崩塌。API 支持传入账号 ID 数组进行批量查询,配合分页和增量拉取策略,把“每小时刷一次阅读量曲线”这种动作变成后台静默运行的调度任务。第二个优势是历史纵深。公众号官方后台只保留近三十天数据,过期即不可追溯,而 API 侧的历史回溯能力可以拉到近五年,删文监测、改稿比对、竞品内容策略的长期演变,才有可分析的素材。第三个优势是与 BI 和内部系统的无缝对接:JSON 返回的数据可以直接流入数据仓库、企业微信机器人或自建看板,分析维度和更新频率由使用方定义,而不是由平台预设。
代价也同样明确。API 是一条需要工程能力的路径:认证、传参、分页、落库、限流控制、失败重试,每一个环节都需要技术同学介入。没有开发资源的小团队,拿到 API Key 之后面对文档和 JSON 返回体,往往寸步难行。
飞书插件地址:多平台数据采集助手

飞书插件的底牌:把“最后一百米”压缩到零
飞书插件的设计逻辑完全不同。它不试图把数据送到你的服务器,而是直接把数据送进运营人员每天已经在用的那张多维表格里。在飞书应用市场安装“多平台数据采集助手”插件后,输入公众号名称,账号数据和作品数据就会自动写入表格,支持定时任务自动更新,数据发生变化还可以推送到飞书群。全程不需要写一行代码,不需要理解什么叫“分页参数”,也不需要维护任何服务器。
它的优势集中在低门槛与即时可用。一个运营人员早上打开多维表格,看到的就是昨天竞品账号的最新阅读数、点赞数和发文列表,直接在这一张表上做排序、筛选、标记和简单汇总,工作流没有任何断裂。对于日常几十个关键词或账号的常规监测,飞书插件的响应速度和操作便利性是 API 无法在体验层面替代的。但它的边界也很清晰:数据以表格为终点,难以直接进入生产系统做二次加工;处理规模偏向“日常常规采集”,面对大批量历史回溯或高频并发任务时力不从心;而且插件本身由第三方维护,深度定制和字段扩展的空间远小于直接对接 API。
真正的选型问题:不是“哪个更好”,而是“谁来用、数据去哪”
把两条路径放在一起看,选型的判断标准就变得具体了。如果你的数据终点是一张供人阅读和轻量操作的表格,执行者是运营人员,采集范围是日常竞品监测和选题参考,飞书插件是更短路径的选择。它把技术门槛降到了零,把“从采集到看到”的时间压缩到了插件安装和一次配置之内。g.jzl.com 的文章也明确将飞书插件定位为“运营人员首选”和“日常运营首选”,理由正在于此。
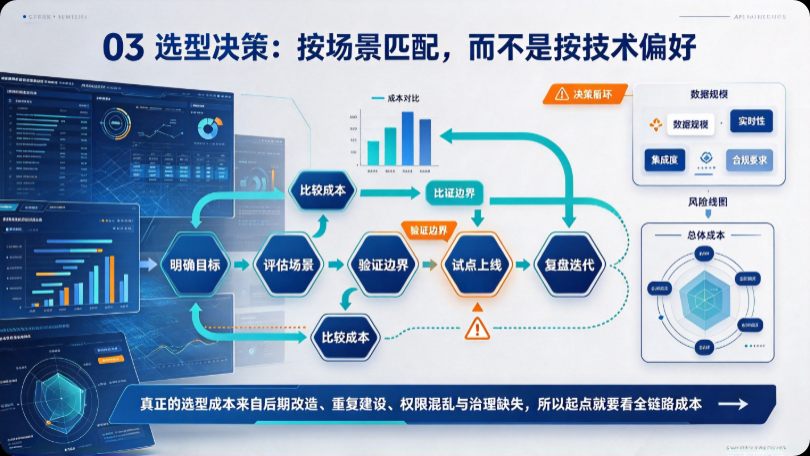
反过来,如果数据需要进入 BI 系统、选题库或自有数据仓库,使用者包含分析师或技术团队,采集涉及历史回溯、高频监测或多账号矩阵的批量处理,API 接口是唯一能承接这些需求的形态。它多出来的那层工程成本,换来的是数据的流动性、可扩展性和与业务系统深度耦合的能力。极致了数据的判断很直接:“日更选题用飞书,系统级集成用 API”,两者之间并不存在谁取代谁,而是数据规模和使用场景的自然分工。
对于同时存在两种需求的团队,更务实的做法是让两者各司其职:飞书插件承担日常运营层的轻量监测和快速浏览,API 承担进入数据仓库和 BI 分析的那条“重数据”管线。数据采集不是一场工具竞赛,选那条数据能顺畅走到终点、人也能轻松驾驭的路,比选一条“技术上更高级”的路重要得多。