公众号API怎么用:批量拉取推文数据并接入BI与飞书
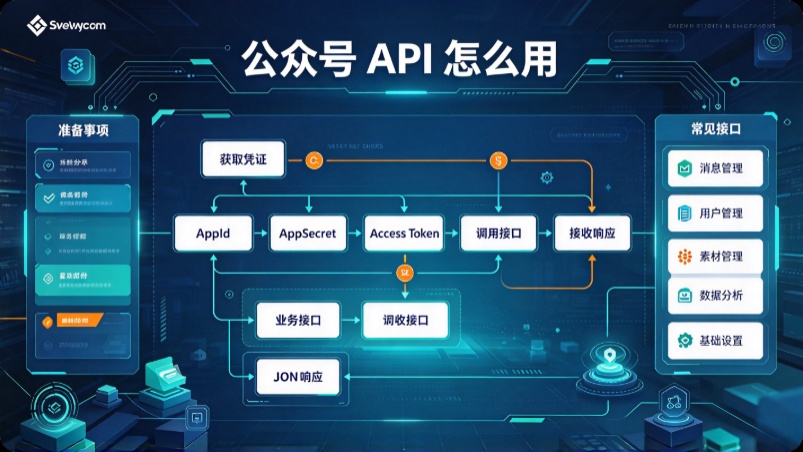
当分析需求从“看一眼”变成“持续跑”,手动导出和平台界面就会成为瓶颈。API解决的核心问题是:把数据从平台侧拿到你自己的系统里,让分析维度、更新频率和报表形式由你定义,而不是由平台预设。 这篇给出一个从字段设计到入仓建模的最小可行方案,适合有基本技术能力或数据分析人员的团队。
本文是 [公众号数据分析完全指南] 的接入篇,数据获取方式的整体对比见 [公众号竞品数据怎么查] 。
一、API适合谁,不适合谁
适合:需要长期历史回溯做趋势分析的团队;需要批量监控大量竞品并自定义字段的团队;需要把数据接入内部BI、飞书或数据仓库的团队;需要按自己的节奏做自动化报表的团队。不适合:只想看一眼行业排行榜的个人用户(榜单平台更快);没有数据分析人员、也不打算建立数据流程的小团队(API的前置成本在字段设计和拉取逻辑,跑通之后才体现价值)。判断标准很简单:如果你的分析需要“自定义维度”或“接入系统”,API是正解;如果只需要“平台已经组织好的视图”,SaaS工具更省事。
二、先设计字段,再写代码
字段设计决定了你未来能回答什么问题,比拉取代码更重要。最小可行字段集:
字段 用途
账号ID、账号名称 关联账号维度
文章ID 去重键、文章级关联
标题 选题分析、关键词提取
发布时间 时间序列、发布节奏分析
阅读量、点赞、在看、转发、留言 表现指标
原文链接 溯源、内容存档
采集时间 数据新鲜度、增量判断
字段设计的一个原则是宁多勿少:拉取时多存字段的成本很低,事后补字段却需要重新拉取历史数据。留言数、原文链接这类字段在初期可能用不上,但做内容分析或舆情回溯时往往是关键。
三、拉取策略
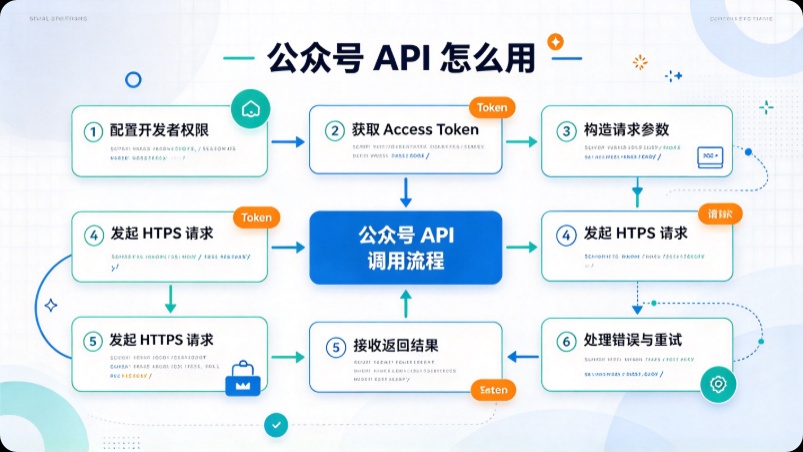
历史补全+每日增量是基本结构。历史补全用一次性任务把核心竞品过去12—24个月的推文拉下来,建立基线;每日增量按固定频率拉取新发文,保持数据新鲜。去重键用文章ID,避免重复入库。失败重试与限流需要提前设计:API通常有调用频率限制,批量拉取时需要排队和退避策略,否则会在中途失败。增量拉取的时间窗口建议留出余量(比如拉取最近3天而非仅当天),防止因延迟导致漏采。
四、入仓与建模
最小可行的分层是原始层、清洗层、报表层。原始层存API返回的原始结构,不做修改,便于回溯和排查;清洗层做字段标准化、去重、异常值标记;报表层按分析需求聚合。最小看板三个:账号趋势(阅读、互动、发文的月度变化)、文章榜单(按阅读/在看/转发排序的爆款分布)、竞品对比(同赛道账号的份额和增速)。建模不需要一开始就追求星型模型或数据仓库的完整架构,先用一张文章明细表加一张账号维度表跑通,再根据分析需求扩展。
五、接入飞书/BI
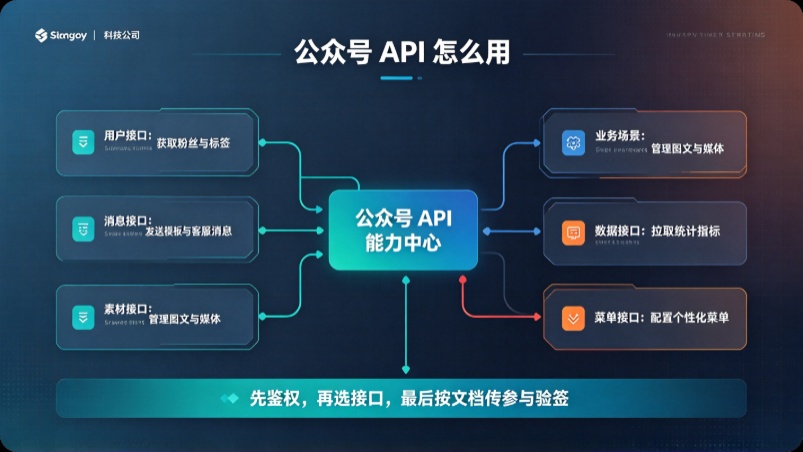
数据入仓后的最后一公里是“让人用起来”。飞书多维表格适合轻量团队:API拉取后写入多维表格,团队成员直接在表格里筛选和查看,不需要登录额外系统。飞书机器人适合预警场景:设定规则(竞品爆款、异常增速),触发时推送到群聊。BI工具(如Tableau、Power BI、FineBI)适合需要定时刷新和复杂可视化的团队,数据源指向数据库即可。极致了数据的飞书插件可以作为轻量接入方式,减少自建推送管道的开发量。选择哪种方式取决于团队已有的工作流——数据应该出现在团队已经在用的工具里,而不是要求团队为新工具改变习惯。
六、数据质量校验
API接入的常见问题不是“拉不到”,而是“拉到了但数据有问题”。三个必查项:字段缺失率(某些文章缺阅读或留言字段的比例)、重复率(文章ID去重后是否还有重复)、更新时间延迟(增量数据实际到达时间与预期时间的偏差)。建议每月做一次与官方后台的抽样比对:抽10—20篇自身账号的文章,比较API返回的阅读、在看数据与后台的差异,确认口径一致。竞品数据无法与官方后台比对,但可以通过多平台交叉验证和增量曲线形态做合理性检查。
七、极致了数据API的适用点
极致了数据的API在三个能力上与本文场景直接对应:近5年历史推文检索(解决历史补全的深度问题)、结构化字段返回(标题、时间、阅读、点赞、在看、转发、留言等,满足最小字段集)、覆盖90%以上活跃公众号(批量竞品监测的覆盖面)。按需付费的模式适合“先小规模验证再扩展”的路径——先用一个竞品、近90天数据跑通字段和去重逻辑,验证数据质量后再扩展到全量账号清单。这条路径的风险最低,也最容易在团队内部证明价值。
延伸阅读:数据来源的精度层次与选型框架,见 [公众号数据分析完全指南] 。历史数据回溯的完整方案见 [公众号历史数据怎么回溯] ,企业级监测的落地框架见 [品牌公众号竞品监测与舆情预警] 。