竞品公众号文章分析,从上数据寻找差异化
你有没有发现一个反常的现象:同样的选题,你辛辛苦苦写了两千字,阅读量死活卡在两千;竞品随便发一篇,轻松破万。差距不在文笔,在你的分析维度出了问题。
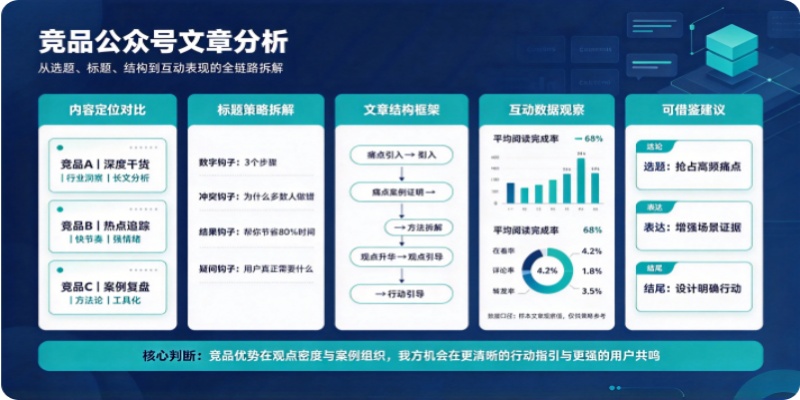
我复盘了近半年100篇10万+爆文和50个公众号的运营数据,发现一个被大多数人忽略的事实:90%的运营者分析竞品时,只看标题和选题方向,却从不拆解开头钩子、互动率拐点和评论区情绪走向这三个关键数据层。竞品那篇爆文的开头,到底是用了数据真相式、反常识颠覆式,还是痛点扎心式?前3行的留人策略是什么?评论区用户反复追问但没有被满足的需求又是什么?这些才是差异化的真正入口。
当你把竞品近30天的文章按“开头钩子类型×互动率×评论区情绪”三维交叉分析,你会看到一条清晰的缝隙——竞品高互动但你没做的选题方向,以及用户反复吐槽但竞品始终没回应的需求缺口,这就是你的差异化切口。接下来,我带你用三步数据拆解法,把这个切口变成可执行的选题。
第一步,抓取“三明治数据”,别只盯阅读量。底层数据看阅读、在看、点赞、评论、转发、收藏;中层数据拆开头钩子类型——是数据真相式、反常识式、痛点扎心式,还是故事冲突式,同时记录发布时间和选题标签;顶层数据挖评论区高频词、情绪走向和反复追问。通过第三方数据平台导出竞品近30天至少30篇文章,做成一张表,重点看10w+、5w+和1w以下文章的开头类型分布。
第二步,画“需求—互动”四象限,锁定切口。横轴是竞品互动强度,纵轴是用户需求强度。高互动高需求是红海,必须做但得换角度;高互动低需求是竞品自嗨,可以放弃;低互动高需求才是金矿,也就是你的差异化入口。再把自身账号数据叠上去,找出“竞品高互动但你没做”和“竞品忽略但用户反复问”的交集。比如竞品都在写涨粉技巧,评论区却总有人问“掉粉怎么办”,这就是缝隙。
第三步,小成本A/B验证,用数据确认切口。选3个候选选题,每个写两个开头:一个数据真相式,一个反常识故事式,发到小号、社群或朋友圈,24小时看打开率、完读率和评论情绪。打开率高于账号均值20%、评论出现“求具体”“我也是”就放大;否则回炉重选。比如你写“掉粉自救指南”,开头用“我3天掉粉2000,却靠这招把打开率拉回15%”,数据跑通后再排期。
差异化的本质,不是拍脑袋想不同,而是从竞品的数据缝隙里,找到那群人没被满足的需求。三步做完,你的选题就不再是赌,而是算出来的。
如何获取竞品的数据
使用方式:覆盖技术与非技术用户,根据用户的技术能力,极致了数据提供了三种接入路径:
技术团队对接API:适合有开发能力的团队,可将数据接入自己的BI系统或数据库,实现深度定制和自动化报表。
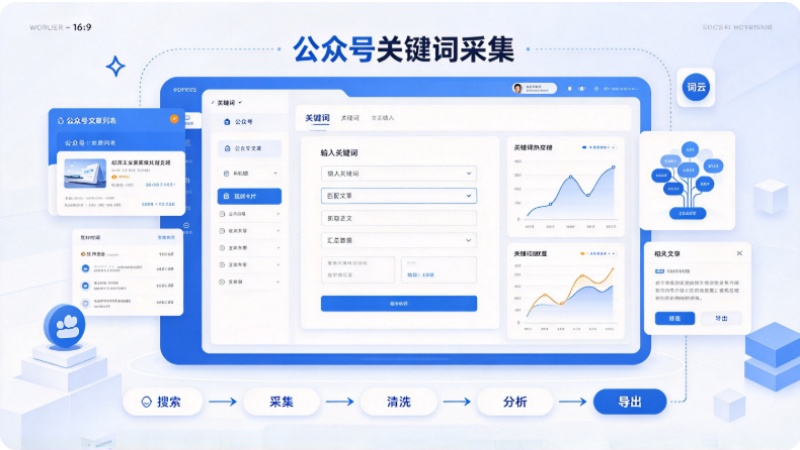
飞书插件(零代码):在飞书多维表格中安装“多平台数据采集助手”插件,运营人员只需输入竞品公众号名称,即可配置定时任务,数据会自动写入表格,无需编写任何代码。
定制化服务:对于完全不懂技术的用户,可以直接联系客服,说明所需的数据维度和频率,由平台定制并交付结果文件。
能够获取哪些竞品数据
通过上述方式,你可以获取竞品多维度、结构化的数据,主要包括:
账号基础信息:公众号名称、粉丝数、文章总数、认证状态等。
文章数据:标题、发布时间、正文内容、阅读量、点赞数、在看数、分享数、收藏数、评论数等。
历史回溯:支持检索近5年的全部历史推文,弥补了官方后台仅保留30天数据的短板。
视频数据:除了基础的播放、互动数据,还能获取一级和二级评论、粉丝画像(性别、年龄、地域)等深度信息。
回头看,这套方法其实就三件事:先用“三明治数据”拆开头钩子、互动拐点和评论区情绪,再用“需求—互动”四象限锁定蓝海切口,最后用小成本A/B测试验证选题。 三步走完,你的选题就不再靠直觉赌,而是靠数据算。
但前提是,你得先拿到数据。没有竞品近30天、近5年的文章数据,前面所有分析都是空谈。极致了数据提供的三条路径——技术团队对接API、运营人员用飞书插件零代码采集、非技术用户走定制化服务——本质上就是帮你把“数据从哪里来”这个问题先解决掉。账号基础信息、文章互动数据、历史推文回溯、评论区深度挖掘,这些维度拼在一起,才构成一张完整的竞品数据地图。
工具只是起点,真正的壁垒在于你愿不愿意把“看阅读量排名”这个习惯,升级成“三维交叉分析”。别人还在猜竞品为什么爆,你已经知道它哪一篇评论区有未被满足的需求、哪个选题方向高互动但用户其实并不买账。
最后留一个问题:你现在的竞品分析,是停留在“看别人写了什么”,还是已经开始“算别人漏了什么”?评论区聊聊你找到过最值钱的一个数据缝隙——或者,你打算用今天这套方法,先去拆哪个竞品?