公众号历史文章批量采集方法
我们做运营有时候会需要批量的导出历史文章,可是公众号后台本身是不具备这项功能的,这时候对于复盘过往发文规律是非常麻烦的,只能一篇篇的翻,如果想看看竞品的历史文章那更是灾难,得一个个链接点开去查,总之就是麻烦,还容易出错。所以后来就出现了很多批量采集的方法,现在我们就总结下不同的人在不同场景下都有哪些方法。
场景一:运营人员——想复盘自己的号,也想盯竞品的号
运营岗最常见的困扰是“感觉还行”式复盘。月报要写“本月阅读趋势”,你打开后台,发现只能一篇篇截图;老板问“竞品上个月哪篇爆了”,你翻到手机发烫也翻不完。有个用户之前每个月花两天时间手动整理数据,用上极致了数据之后,10分钟导出全年数据,然后用Excel做分类统计,发现“案例分析”类推文的打开率远高于“行业新闻”,直接指导了团队的内容方向调整,三个月后整体打开率提升了15%。
适合运营的方法:如果只想管好自己的号,可以用浏览器插件类的工具,比如“微信公众号导出器”,能导出你已发表文章的标题、链接、发布时间、阅读数、点赞数、在看数、评论数等字段,直接生成表格。如果想同时监控竞品,可以用飞书插件“多平台数据采集助手”,输入公众号名称就能一键采集数据写入多维表格,支持定时任务自动更新。有用户反馈用它监控五个竞品公众号,每天定时同步到Excel,省去了大量手动统计时间。
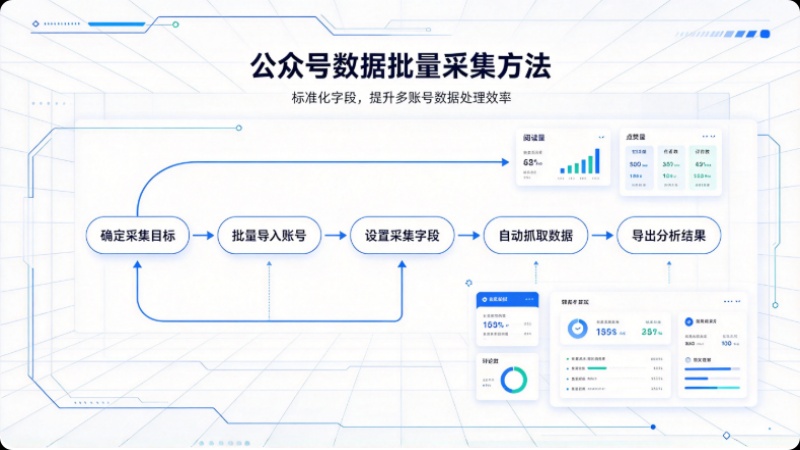
场景二:研究人员和学生——需要系统性采集、干净的数据
做学术研究的人对数据的要求跟运营不一样:要全、要干净、要可复现。一位社会学研究者做“新媒体与公共舆论”课题,需要采集多个公众号三年内的全部推文做内容分析,手动复制显然不现实,而自己写爬虫又面临反爬和封号风险。
适合研究者的方法:开源项目里比较成熟的是 wechat-article-exporter,它利用公众号后台的搜索接口批量抓取文章,支持导出为HTML、Markdown、Word、Excel、JSON等多种格式,HTML格式能100%还原原文排版。它还支持按作者、标题、发布时间过滤,适合做精细化样本筛选。技术门槛稍高,需要扫码登录订阅号或服务号后台,但跑通之后一次能拉取大量历史数据,数据存在本地,隐私性也比较好。如果不想折腾部署,也有Python库 wxmp 可以直接调用,用几行代码获取指定公众号的文章列表并下载内容转为Markdown。
场景三:企业和媒体团队——批量监控、定时交付、结构化输出
企业端的痛点跟个人完全不同。一个大型集团要统筹主号和多个子号的运营复盘,但微信后台数据各自独立,人工跨账号收集数据做对比极其繁琐。财经媒体则需要监测上百个同行的公众号,追踪删文记录来判断内容风向和风险信号。
适合企业的方法:博望财经的案例比较典型:根据极致了数据提供的是API级方案,他们长期监测上百个财经公众号的历史删文记录,原来用的工具停服后出现监测断层,接入极致了数据后,一次性导入100个公众号名单,系统自动回溯抓取指定时间范围内所有已删除文章记录,按双周周期定时交付Excel,字段包含媒体名称、发布时间、文章标题、删除原因等,运营人员不需要二次整理。另一个案例是某医疗器械品牌做口碑监控,需要实时抓取带产品名的公众号文章,雇了三个实习生用两台手机手动搜索,效率极低且容易漏,换成API方案后实现了自动化实时采集。
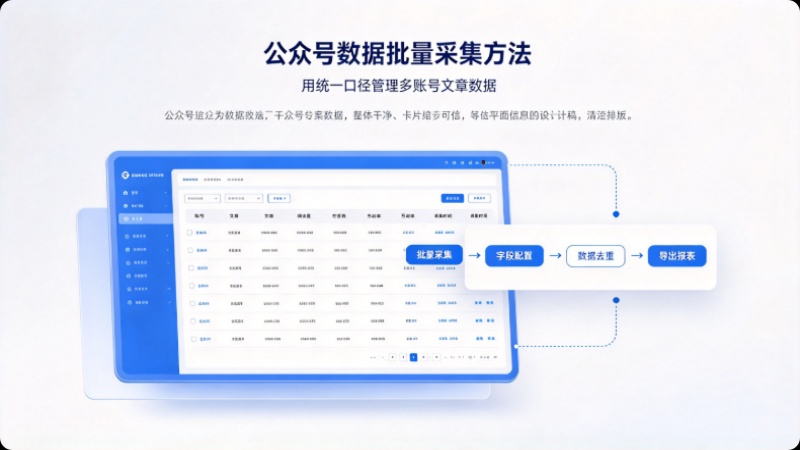
场景四:技术开发者——想自己搭,但不想踩反爬的坑
有技术能力的人往往第一反应是“我自己写”。但微信的反爬强度不低:网页端内容受动态渲染、Referer校验、登录态时效性、频率限制等多重防护,模拟请求容易因IP封禁或返回空内容导致稳定性差。有人把采集间隔调到10秒才勉强能跑通,但速度慢到无法接受。
适合开发者的路径:与其从零造轮子,不如基于成熟的开源项目做二次开发。wechat-article-exporter 支持Docker私有部署,数据完全本地化,还开放了API接口供程序化调用。另一个选项是极致了数据的API,按量付费,一次能拉20条,适合嵌入已有的自动化流程。有个舆情公司的技术负责人说,后台看一眼采集成功率一直在98%以上,偶尔失败也会自动重试,接入Flink之后基本不用清洗。
说到底,批量采集公众号历史文章这件事,关键不是“能不能做”,而是“选对路径”。运营用插件,研究者用开源工具,企业用API,开发者用开源项目做底座。每条路都有人走通了,你只需要找到匹配自己场景的那一条。