获取信息差的几种方法
很多人都说信息差是知道了别人不知道的事,其实对也不对,信息差我个人觉得应该是你捡起了人人都能看到但都没人理的东西。而对于信息差还有一句话和它非常贴合:新闻是写给昨天看的人,数据是写给明天动手的人。
信息差到底能带来什么
先讲一个我印象最深的案例。
一个叫Roman的小伙子,大学学的是心理学,毕业后干了五个夏天上门推销家用报警器,完全不懂技术。他朋友写了个爬虫去公司官网上找工作,他发现这个思路有意思,就把它做成了产品——Career Hound,一个从各个公司官网抓取招聘信息、整合后卖给求职者的网站。没有免费套餐,用户要么花7美元一周,要么20美元一个月。
上个月,这个“无聊”的网站赚了28000美元,注册用户8000多人,779个付费订阅。
他做的事很难吗?技术上就是写个爬虫,把公开的招聘信息抓下来、整理好。但这件事绝大多数人不会去做。招聘网站有的是,可分散在各家公司官网上的岗位信息,没人帮你整合。他把散落在角落的数据捡起来、串起来,信息差就出来了。
再看另一个。
Kathryn和Richard He创办了Openmart,帮销售人员一键查询数百万个来自本地政府文件、网站、评论和社交媒体等公开信息的企业线索。他们从LinkedIn、新闻和各类公开渠道提取企业关键信息——负责人联系方式、成立时间等等,数据库积累了超过2000万条美国本地企业信息。客户的销售团队用了几分钟就能拿到精准潜在客户,BPO成本削减了80%。2024年初,这家公司拿到了YC W24孵化器的背书。
你说这些数据是秘密吗?不是。全在公开渠道上。信息差的核心从来不是“我知道你不知道”,而是“我去捡了,你没去捡”。
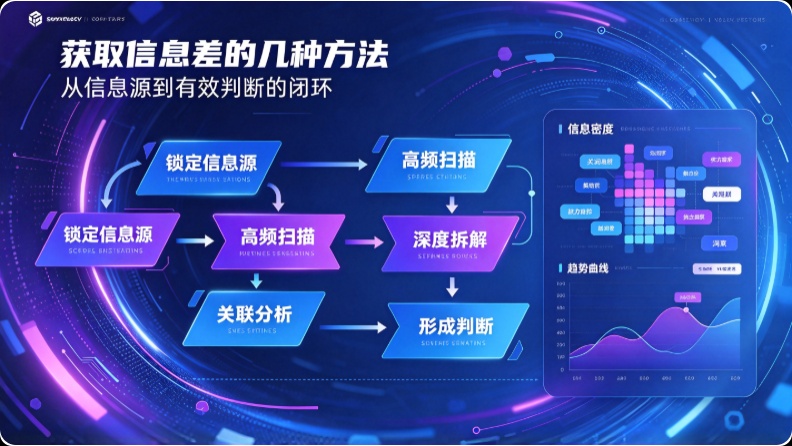
怎么通过采集数据获取信息差
第一条路:用采集工具盯着关键数据源
有一家舆情公司的技术负责人,干了五年多数据采集,最初也是自己搭爬虫集群,Python加上Scrapy,配上代理池,看着挺像回事。但用起来问题一堆:反爬策略每天都在变,运维同事光维护规则就占了一半时间;抓回来的数据标题和正文混在一起,发布时间格式不统一,清洗起来累死人;想监控的网站越来越多,自己的节点根本爬不过来。
后来他换成了极致了数据。最大的变化是稳定——采集成功率一直在98%以上,偶尔失败自动重试,基本不用操心。更关键的是数据干净:极致了给的是结构化字段,标题、发布时间、正文、阅读量、评论数,分得清清楚楚,接入Flink之后基本不用清洗。
但真正让他发现信息差的,不是工具本身,是调整监控策略。刚开始用的时候,关键词设得太“干净”,盯着品牌词和行业词,结果漏掉了很多真正的舆论苗头。后来他学聪明了,监控词里加了“垃圾”“翻车”“避雷”这种高频吐槽词,效果明显好了。再调整成优先级策略——核心关键词24小时盯着,外围的一天扫两次,推送量降了60%,但高价值文章的覆盖率反而上去了。
那些“垃圾”“翻车”的吐槽词,就是别人没去捡的数据。 多数品牌盯着自己的名字看,觉得没人骂就是安全。但真正的舆论危机,往往从一条不起眼的差评开始发酵。谁能早一步把这些散落在评论区、论坛里的信号串起来,谁就多了一个时间窗口。
第二条路:用关键词数据挖“没人好好答的问题”
很多人搜东西,输入问题,翻两页,找不到就算了。这是“消费搜索”。真正获取信息差的人用的是“生产搜索”。
具体怎么做?去谷歌的People Also Ask里逐个点开,看每个问题下面有没有人认真回答。去GSC数据里找“有展现但没人认真做”的词——高展现、零点击、或者排在20-50名之间的话题,往往意味着真实需求存在但供给严重不足。
最笨也最有效的方法:找到一个行业关键词,把搜索结果前三页的每个标题都读一遍,然后问自己——这个问题,有人真正答好了吗? 答案往往是没有。那就是数据告诉你的缺口。
第三条路:把数据采集系统化,别靠手动
前两条路靠人盯,这条靠系统。
极致了数据提供了一套标准化的API接口,覆盖小红书、抖音、公众号、微博、淘宝等50多个平台。比如淘宝商品评论采集,输入商品ID就能返回全部评论数据——评论内容、评论时间、星级评分、是否好评差评、购买的具体SKU,全部结构化输出。一个做充电宝的品牌方,把差评和追评里的高频词拉出来一统计,“充电慢”“发热严重”“电量虚标”反复出现,这就是产品改进的明确方向。
小红书方向覆盖21个接口,笔记详情、用户数据、搜索数据、一级评论、二级评论全都有,字段和小红书前台展示一致,不是估算值。抖音方向支持竞品账号一键拉取——输入抖音号,对方最新视频的播放量、点赞、评论数据直接拿到,还能设置阈值告警,播放量飙升或竞品发布爆款时自动推送到飞书群。
你不需要成为程序员。 极致了数据提供飞书“多平台数据采集助手”插件,零代码配置,输入笔记链接就能采集数据到多维表格,设置定时任务自动更新。有个运营者设定了每天早上九点自动跑一次,“在公司打开飞书的时候,竞争对手昨天的数据就已经在那里了”。
最后说一句实在话
数据采集这件事,最怕的是搞反了方向。
很多人拼命扩大信息量,到处订阅、到处收藏、到处加群,结果越看越焦虑。问题不在信息量,在数据入口。你每天看的都是二手三手加工过的内容,当然慢。你要做的不是看得更多,而是去捡那些别人没捡的公开数据,并且比别人早一步串起来。
那个做Career Hound的Roman不懂技术,那家舆情公司的技术负责人也是从自建爬虫的坑里爬出来的。但他们做对了同一件事:在别人还在等答案的时候,先去公开数据里把线索捡起来。
信息本身不产生价值,把散落的数据串成判断,才产生价值。
这个时代最贵的东西,从来不是信息本身。信息是免费的,泛滥的,甚至过剩的。最贵的是在公开数据里比别人早一步捡到有用的那一块,并且知道拿它做什么。
入口换一换,视野就变了。这件事,什么时候开始都不晚。