如何提高API数据采集的效率与稳定性
先搞懂:API数据采集到底是什么
说白了,API数据采集就是通过一套标准化的接口,从别人的服务器上自动把数据"搬"到你自己这里来。你不用手动去网页上一条一条复制粘贴,也不用写一堆爬虫去跟网站的反爬机制斗智斗勇——对方把数据整理好,放在一个固定的地址,你按约定的格式去拿就行。
举个最直观的例子:你想看天气,打开一个天气APP就直接出结果,背后就是APP在调用气象部门的API;你做电商想监控竞品价格,也是通过API定时去拉取对方的商品信息。跟传统的网页爬虫比,API采集的好处很明显:数据结构规整、获取速度快、合规风险低,而且对方接口稳定的话,你基本不用天天维护。
但问题也来了——拿数据的人多了,API就像一个热门窗口,大家都挤着去,要么速度慢得离谱,要么直接被限流拒之门外。所以怎么又快又稳地把数据拿到手,就成了一门实打实的手艺。
想提速?这几个技巧先用上
效率这个事儿,核心就一句话:少做无用功,把能用的资源都用足。
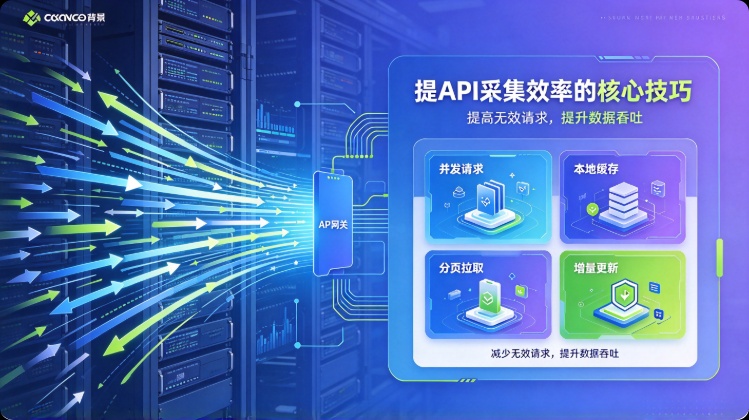
第一,能并发就别串行。很多新手写采集脚本,就是一个请求发出去,等返回了再发下一个。这种写法拿个几十条数据还行,真到了几万、几十万条的量级,跑到天荒地老。正确做法是开多线程或者协程,同时发几十个甚至几百个请求,只要不超过对方的限流阈值就行。Python里用asyncio、Go里用goroutine,都是干这个的。
第二,只拿你需要的字段。很多API返回的JSON一大串,里面八成都不是你要的。你在请求参数里加上字段筛选,只拉取真正用得上的那几个字段,传输的数据量能砍掉一大半,处理起来也更快。
第三,分页和增量更新搞起来。别每次都全量拉取所有数据,那样又慢又浪费。第一次全量拿完之后,后面只拉取新增或变更的部分就行。很多API都支持按时间戳或者更新标记来做增量,善用这个功能,日常采集的压力能小很多。
第四,本地缓存中间结果。同一份数据如果短时间内要被反复用,就别每次都去请求API了。先缓存在本地数据库或者Redis里,过一段时间再统一更新,既减轻了对方服务器的压力,你自己的读取速度也快。
稳字当头:别让采集脚本三天两头崩
速度快但天天崩,跟速度慢但稳稳当当,后者其实更让人省心。做数据采集,稳定性永远是第一位的。
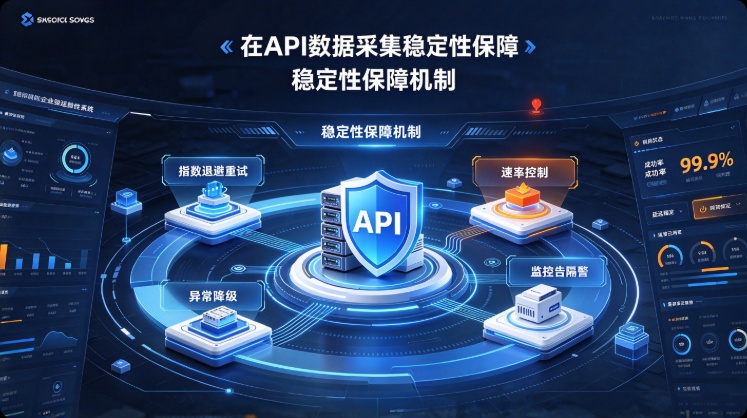
首先,重试机制必须有。网络波动、对方服务器临时抽风,都是常有的事。请求失败了别直接报错退出,等个几秒再试,一般试个两三次就成功了。但注意别无脑狂试,那样只会把对方服务器搞崩,最后把你封了。指数退避是个不错的策略——第一次等1秒,第二次等2秒,第三次等4秒,慢慢来。
其次,限流和速率控制要做好。每个API都有自己的调用频率限制,比如每分钟最多100次。你要是超过了,轻则返回429错误,重则直接封你的IP和密钥。所以一定要自己做个限流,心里有数对方的阈值是多少,卡在阈值下面一点点跑,既不浪费额度,也不会触发封禁。
再者,做好异常分类和降级。不是所有错误都值得重试——参数写错了、密钥过期了,你再试一百次也没用。把错误分个类:网络超时、5xx错误这些可以重试;4xx错误、权限问题这些直接记录下来告警,别浪费时间。同时准备好降级方案:主用接口挂了,自动切到备用的数据源或者缓存里的旧数据,保证业务不停。
最后,监控和日志不能少。脚本跑没跑成功、成功率多少、耗时多长,这些都要记录下来。出问题了第一时间能发现,而不是等业务方找上门来说数据不对了才反应过来。
这些工具和资源,帮你少走弯路
很多活儿其实不用自己从零造轮子,现成的工具已经很好用了。
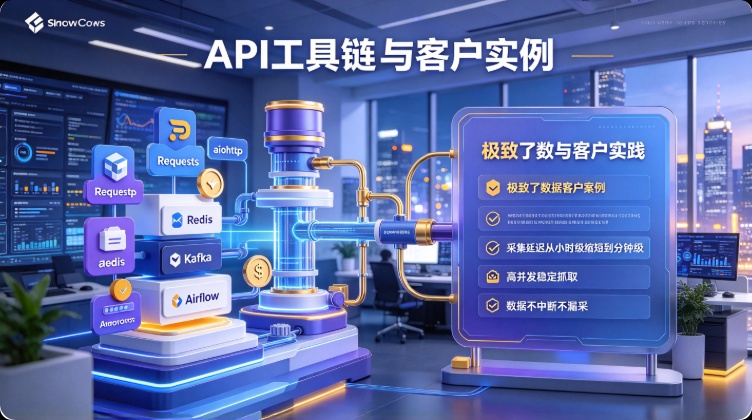
采集框架方面,Python生态里的Requests加httpx是基础组合,要做大规模异步采集可以用aiohttp;Go语言里的colly和resty也很顺手。如果不想写太多代码,Airflow和Dagster这类调度工具可以帮你把采集任务编排起来,定时跑、失败重试、依赖管理都帮你做好了。
中间件和存储方面,Redis做缓存和限流计数器是标配;消息队列比如Kafka、RabbitMQ,适合采集量大、需要削峰填谷的场景——采集到的数据先扔队列里,后面慢慢消费,不会把下游系统冲垮。
第三方API服务方面,如果是做网页数据采集但不想自己维护爬虫,可以考虑用Crawlbase、ScraperAPI这类服务,他们帮你处理代理、反爬、验证码这些脏活累活,你只管发请求拿数据就行。
真实案例:月处理10亿请求,成功率99.96%是怎么做到的
说个真实的案例。一家商业智能平台用Crawlbase的API来做大规模网页数据采集,从最初每月几亿请求,一路扩展到了每月近10亿次请求的规模。六个月的生产运行期间,总共处理了55.2亿次成功请求,平均成功率稳定在99.96%——哪怕月流量从几百万涨到了10亿,成功率的波动幅度也只有0.22个百分点。
他们能做到这个水平,靠的就是前面说的那套组合拳:合理的并发控制加自动重试机制,把网络波动和临时失败的影响降到最低;智能的速率调节,根据目标网站的响应动态调整请求频率,既不浪费带宽也不会触发封禁;还有完整的监控和告警体系,任何异常都能在几分钟内被发现和处理。
这个案例其实说明了一个道理:API采集的效率和稳定性不是对立的,而是相辅相成的——你把重试、限流、监控这些基础工作做扎实了,系统自然就能又快又稳地跑起来,规模也能跟着业务一起往上长。