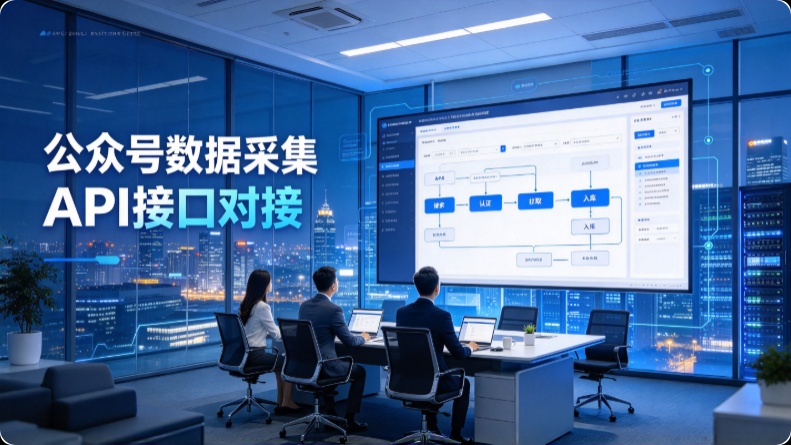
公众号数据采集API接口对接
公众号运营最尴尬的事情就是数据就放在哪里,可就是拿不到,因为官方后台的机制逼出了一个千亿级数据刚需,官方的接口权限设计从开始就是服务与自我管理,也就是说只能拉取自己账号的图文数据,且只保留30天的数据窗口,别人的数据更是不用想。这样的设定是完全无法满足运营者的需求的,并且随着数据的增长,手扒更是噩梦般的存在。
于是,一个尖锐的矛盾浮现出来:需求是真实的、普遍的、刚性的,但合规供给几乎是空白的。
三条路摆在面前,两条是死路
市面上获取公众号数据的技术路径,说穿了只有三条。
第一条:微信官方API。 数据源最权威,合规性最清晰,但只能拉自己的账号,竞品数据一律拿不到,且有T+1延迟。对需要做竞品分析和行业监测的团队来说,这条路在起点上就已经堵死了。
第二条:自建爬虫。 理论上能抓全量公开推文,但微信的反爬体系在过去几年经历了数十轮升级。设备指纹识别、登录态校验、IP限频、接口参数动态化,每一项都在抬高门槛。一个实际经验是:自己写的爬虫“跑了不到两周就放弃了”,因为接口变动和封禁的维护成本远超预期。更关键的是合规风险。2025年深圳中院的判例已经把边界划得很清楚——绕开技术保护措施进行自动化采集,即便不涉及用户隐私,也可能构成不正当竞争。微信平台的整体数据资源被认定为享有竞争性权益的商业资产。这意味着自建爬虫不仅技术脆弱,法律上也是高危动作。
第三条:第三方合规数据API。 这类服务的定位很明确:不绕开微信的技术保护措施,而是通过合规渠道(如搜狗微信公开检索能力)封装数据接口,向用户提供结构化的公众号数据。它的核心价值是把“能不能拿到数据”的技术不确定性和“拿了数据会不会出事”的合规不确定性,一次性打包解决掉。
对于绝大多数有数据采集需求的团队来说,第三条路是当前唯一可规模化落地的选择。问题只剩下一个:选哪家。
极致了数据:一个把“采集+合规+接入”打包解决的样本.
在第三方公众号数据服务中,极致了数据是一个值得拆解的实际案例,因为它恰好覆盖了从需求识别到工程落地的完整链条。
先看数据能力。极致了数据的公众号API覆盖50个数据方向,核心包括四层:账号基础数据(粉丝数、认证状态、账号主体)、文章列表数据(标题、发布时间、作者、链接)、文章详情与互动数据(正文全文、阅读量、点赞数、在看数、分享数、收藏数、评论数),以及历史数据回溯。关键突破在于历史回溯能力——支持检索公众号的全部历史推文,直接绕开了官方30天窗口的限制。依托搜狗微信的合规检索能力封装,接口覆盖90%以上活跃公众号,新增文章收录延迟仅10到30分钟。
再看接入方式。极致了数据提供了两条并行的路径。技术团队可以直接调用API:注册获取API Key,阅读接口文档,用Postman发一个GET请求测试返回格式,然后接入BI看板或数据库。整个流程不涉及逆向工程或Cookie维护,API Key是唯一凭证。并发调用方面,默认支持5次/秒的并发,20个公众号的数据采集从串行10秒压缩到5路并发2秒,且并发调用不额外加收费用。
对于没有技术人员的运营团队,有一条零代码路线。飞书应用市场的“多平台数据采集助手”插件基于极致了API开发,安装后输入公众号名称即可一键采集数据写入多维表格,支持定时任务自动更新。一个真实的运营团队案例是:用这个飞书插件同时监控五个竞品公众号,每天定时同步到表格,彻底省去了手动统计的时间。另一个用户的做法更“工程化”一些:在n8n中搭建工作流,用定时触发节点每天固定时间执行,向极致了API传入biz参数和API Key拉取最新文章列表,逐篇请求详情后清洗HTML存入飞书文档,并接入AI Agent自动生成选题分析和每日简报,形成了“监听→采集→分析→沉淀”的完整链路。
真正要解决的,从来不是“怎么写代码”
回到搜索“公众号数据采集API接口对接”那个人的真实处境:他不需要一个爬虫教程,他需要的是一个不用自己维护反爬、不用承担合规风险、今天注册明天就能跑通的数据通道。
极致了数据的模式之所以有参考价值,不在于它的技术有多“黑科技”,而在于它把一个原本需要用户自己承担的三重成本——技术维护成本、合规风险成本、时间试错成本——转移到了一个已经完成工程化和合规化的平台上。用户需要做的,只是获取API Key、找到目标公众号的biz参数、把数据写入自己的业务系统。
公众号数据采集这件事,技术难度从来不是最大的门槛。真正的门槛是:在官方闭源、反爬严密、判例趋严的生态里,找到一条既拿得到数据、又睡得着觉的路。 第三方合规API的价值,就在这里。