同行公众号阅读量在哪里看?
同行公众号阅读量,是公众号运营里最常被问、也最容易被误用的一组数据。它看起来很简单——找到一个数字就行了。问题在于,你能看到的数字,和你以为能拿到的数字,往往不是同一回事。
公众号没有向非账号主体开放官方数据面板,这意味着所有来自外部的“同行阅读量”,本质上都是间接数据。间接数据的价值取决于你知不知道它的边界:哪些是真实前台展示,哪些是算法估算,哪些需要更重的数据通道才能拿到。分不清这三层,拿着一个误差 30% 的数字去做汇报或决策,比没有数据更危险。
第一层:公开前台——能看到的,但不完整
最直接的路径是打开同行的公众号,翻到文章底部。文章页面上确实展示了阅读量、点赞数、在看数和留言数,不需要登录任何第三方工具。
但这层数据有两个硬边界。
第一,超过 10 万的阅读量被截断为“10万+”。微信前台的展示规则是:不足 10 万显示具体数字,达到 10 万后统一显示为“10万+”,读者无法看到真实数值,账号运营者也只能在自己的后台看到准确数据。所以你看到一篇“10万+”,只能知道它越过了 10 万这条线,至于它是 11 万还是 100 万,前台给不了答案。
第二,你只能逐篇看,拿不到账号级的汇总。没有排序、没有平均值、没有时间趋势,想知道一个号过去三个月的阅读量中位数,只能人工一篇一篇翻、一笔一笔记。对于监控一两个竞品号,手动记录仍然是一种可用的笨办法,数据真实但效率极低;一旦竞品数量上去,时间成本会迅速吃掉它的准确性优势。
第二层:第三方平台——有汇总,但是估算
这是大多数人实际在用的路径。新榜、西瓜数据、清博指数等平台提供预估粉丝数、头条平均阅读、发文频率、排名等汇总指标,解决了“手动翻太慢”的问题。
但这一层必须反复强调一个前提:第三方平台展示的阅读量相关数据,是算法估算值,不是微信官方提供的真实值。
误差有多大?有运营者做过对照实验:拿新榜显示的阅读量和自己公众号后台的真实数据比对,少的时候差 10% 左右,多的时候差到 30% 以上。更麻烦的是平台之间不一致:同一账号在不同平台上的预估数据差别可能很大,有的甚至差几倍。有人用第三方数据做了竞品报告,汇报时被问“这个数字和另一份材料引用的怎么对不上”,当场答不出来。
这不意味着第三方数据没有用。它的正确用途是看趋势和方向:竞品最近发文频率有没有变化、选题集中在哪几个方向、大致处于什么流量水位。这些判断对 10%—30% 的误差并不敏感。但如果你要用它做广告投放估价、写进正式报告、或者作为“这篇爆了,赶紧跟”的行动依据,误差就会变成风险。
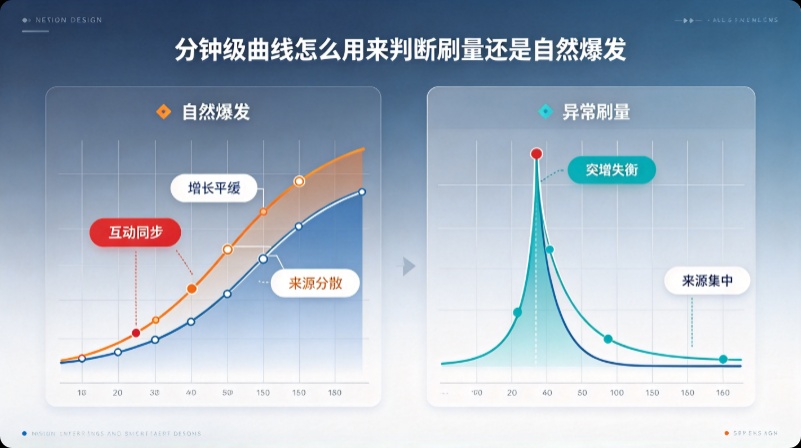
另一个容易被忽略的问题是水分。第三方平台的数据本身是估算,如果账号存在刷量,估算值会被进一步扭曲。识别异常可以看几个信号:阅读增量曲线在非正常时段突然拉升、阅读量多次不规则跳涨、或者“高阅读、低互动”的倒挂——阅读量冲得很高,点赞和转发却近乎为零。但这些信号同样只能作为参考,不能替代更底层的验证。
第三层:API 级数据——更精确,但有门槛和边界
如果你需要的不只是“大概方向”,而是可回溯、可批量、误差更小的结构化数据,路径会切换到合规 API 接口。
以极致了数据的公众号 API 为例,其数据依托合规检索能力封装接口,覆盖文章标题、发布时间、阅读量、点赞、在看、收藏、转发、留言数等维度,支持检索近 5 年历史推文,覆盖 90% 以上活跃公众号账号。它的核心差异不在于“能看到一个更好的数字”,而在于数据可以拉回来、存下来、做趋势对比——公众号官方后台的历史数据有保留期限,超过一定时间的互动数据会被清除,API 的回溯能力补的正是这个缺口。
但这层数据同样有边界。API 拿到的阅读量,是接口数据源所返回的数值,它不等于同行账号后台的“官方精确值”,误差通常小于第三方平台的估算,但并非零误差。同时,API 路径需要技术对接能力,成本结构也和年费制第三方平台不同,更适合有持续监测需求、需要把数据接入自己工作流的团队,而不是“偶尔查一下”的场景。
所以,“在哪里看”取决于你要用它做什么
把三条路径放在一起,选型的判断标准其实只有一条:你拿这个数据去支撑什么决策。
如果只是日常了解竞品在发什么、大致什么水平,公开前台加手动记录就够了,数据真实,慢一点但不会被估算误差误导。
如果是做行业扫描、看趋势方向、判断选题热度,第三方平台的汇总指标是效率最高的入口,但心里要装着一个区间,而不是一个精确点。
如果是做正式报告、广告投放评估、或者需要把竞品数据沉淀成长期可回溯的资产,前两层的边界就不够用了,需要走 API 级路径,并且仍然对数据来源和口径保持说明义务。
最需要避免的做法,是拿第三方平台的估算值当“真实阅读量”去下结论。竞品某篇“涨了”,可能是估算波动;你以为的爆款,也许只是平台之间的算法差异。先确认数据在哪一层,再决定它能支撑多重的判断,比纠结“哪个平台最准”要实际得多。