公众号刷量识别工具的判定逻辑
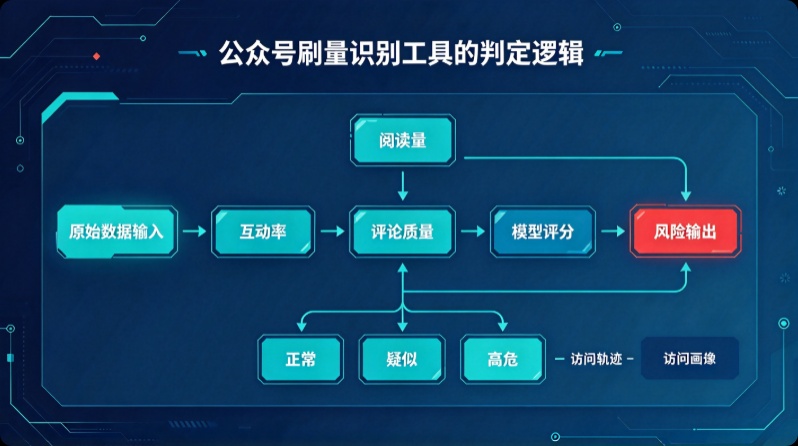
刷量识别工具给出的“嫌疑分”不是凭空来的。它背后通常是一组指标的规则化组合:分钟级增量分布、曲线形态、互动比值、留存质量、来源集中度,以及该账号的历史波动基线。理解这些规则,才能知道工具在什么情况下会误判,也才能把工具输出当成决策依据而不是黑箱结论。
如果你还没有建立刷量形态的基本分类,建议先阅读 公众号刷量识别完整指南 中的三层信号框架。本文重点拆解工具层面的判定逻辑。
工具不是靠单一阈值判刷量
最常见的误解是:阅读量增长太快就会被判刷量。实际上,单看增速极易误伤热点内容和平台推荐带来的正常爆发。成熟工具的判定逻辑通常是多指标加权 + 规则组合,而不是一条红线。
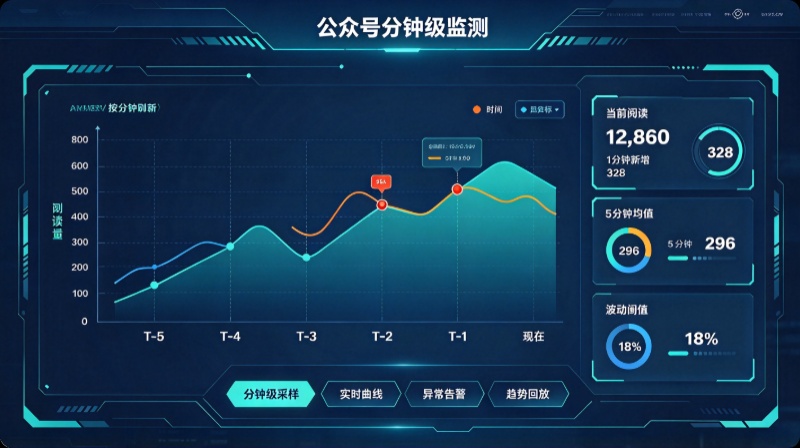
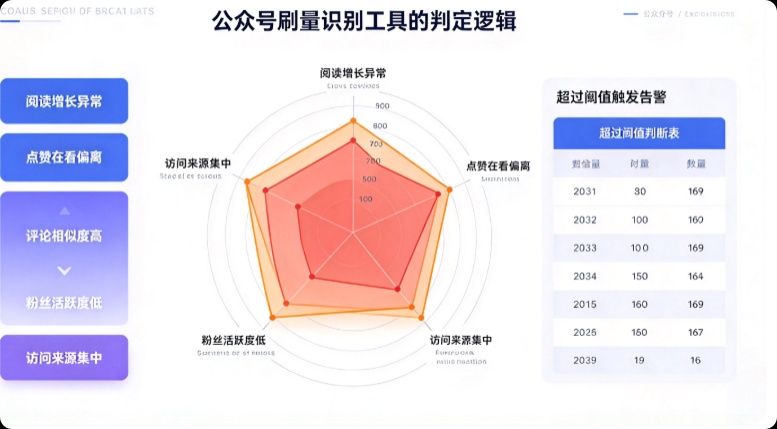
以分钟级监测为例,工具会先建立该账号的历史增量基线,再比较当前文章的增量分布是否落在正常波动区间内。偏离基线只是触发复核,不等于直接判定。真正的判定需要同时满足多个条件,例如:增量曲线出现脉冲式断裂 + 来源高度集中于单一入口 + 互动比值显著低于该号历史中位数。
核心指标一:增量分布的“形态特征”
工具会把阅读增量按分钟或小时切片,识别几种典型形态:
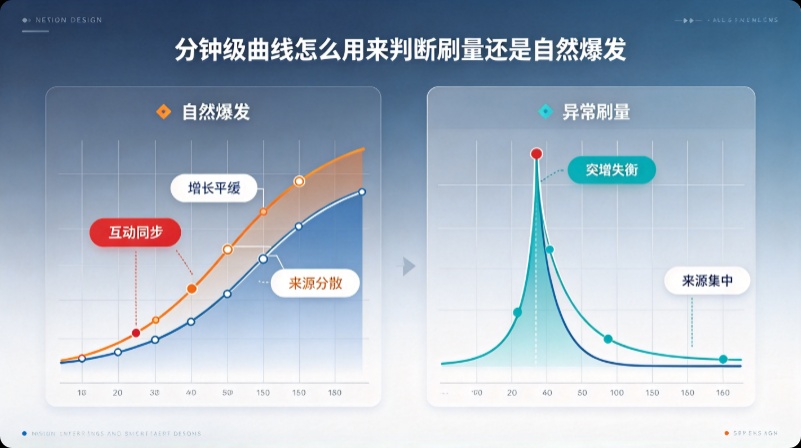
脉冲型:极短时间内注入大量阅读,随后迅速归零;
阶梯型:增量以固定节奏匀速爬升,缺乏自然衰减;
断崖型:平稳增长中突然出现与前后斜率脱节的陡增;
隔日补量型:发文当天正常,第二或第三天出现与衰减趋势不匹配的增量。
这些形态单独出现时可能由自然因素造成,但组合出现时嫌疑显著上升。工具通常会给每种形态分配权重,再汇总成评分。
核心指标二:互动比值与历史波动
阅读可以刷,真实互动很难按比例复制。工具会计算阅读与点赞、在看、评论的比值,并与该账号历史文章的比值分布对比。如果某篇文章的互动比值落在历史分布的极端尾部,或者互动数异常稳定、缺乏正常波动,就会被标记。
这里的关键是“与该号自己比”,而不是与行业平均值比。一个垂直小号的正常互动比值可能远高于泛娱乐大号,用统一阈值会大量误判。
核心指标三:留存与来源结构
有条件的工具会接入留存曲线和来源分布。正常阅读的前 3 秒跳出率通常在 40% 到 60% 之间;如果一篇内容的平均阅读时长异常高而跳出率异常低,数据真实性就值得怀疑。来源结构方面,刷量阅读往往高度集中在“公众号会话”,缺乏朋友圈、搜一搜、看一看等自然入口的分布。
核心指标四:跨文章的一致性
单篇可以伪装,连续多篇很难全部伪装自然。工具会检查该账号近 30 天多篇文章的增量模式是否具有可重复的自然波动。如果每篇的曲线形态、互动比值、来源结构都高度相似,说明数据生产可能来自同一套操作流程。
工具输出应该怎么用
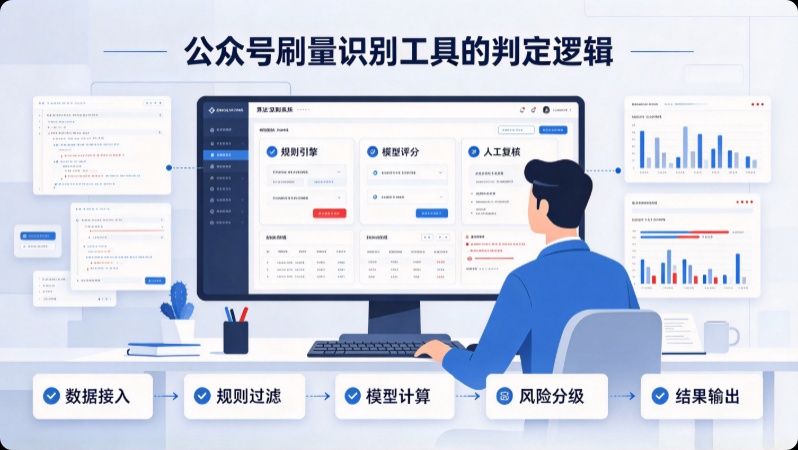
工具给出的是嫌疑评分和证据清单,不是终审判决。正确的用法是:把工具标记的文章作为复核起点,结合人工排查确认自然因素是否可解释。如果你发现某篇文章曲线异常但不确定从哪查起,可以先按 阅读量异常波动的排查步骤 逐项过一遍,再把工具指标作为交叉验证。