公众号矩阵数据API批量查询实战指南:从需求到落地
公众号运营最烦的就是没有一键导出,海量的数据全靠手搓,阅读量、点赞、在看、发文时间、删文情况、竞品动态,全靠人工逐个后台截图、复制粘贴,一个号就算了,号如果多了,这就是灾难,而且后台最多只保留近30天数据,历史数据一旦过期就很难追溯。所以公众号矩阵数据API批量查询就成了矩阵运营的基础设施——用接口代替人工,用批量代替单点,用结构化数据代替零散截图。
本文围绕“公众号矩阵数据API批量查询”这个关键词,从需求场景、可查数据维度、接口调用思路、落地应用和选型建议五个方面展开,帮助运营和技术同学把这件事真正跑通。
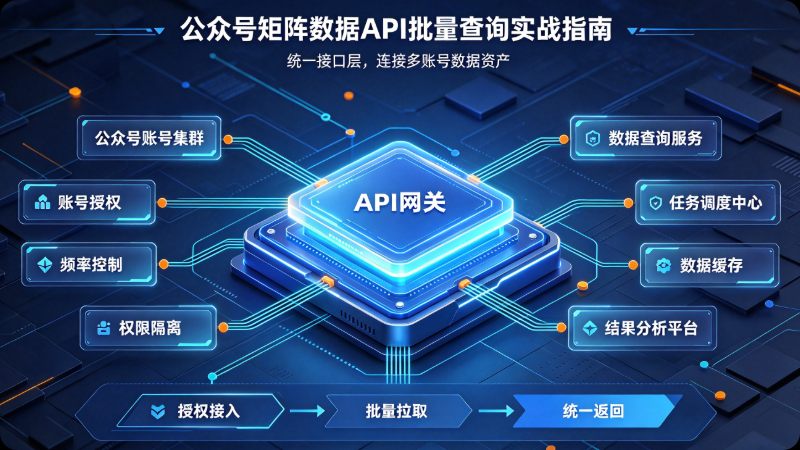
一、为什么矩阵运营必须用API批量查询
先看一个典型场景:一个团队运营20个公众号,每天需要监控阅读量变化、发现异常刷量、追踪竞品爆文、记录删文情况。如果纯人工操作,每个账号至少花3分钟,20个账号就是1小时,而且只能看到当天数据,无法形成历史曲线。更关键的是,人工记录的数据格式不统一,后续做分析还要二次清洗。
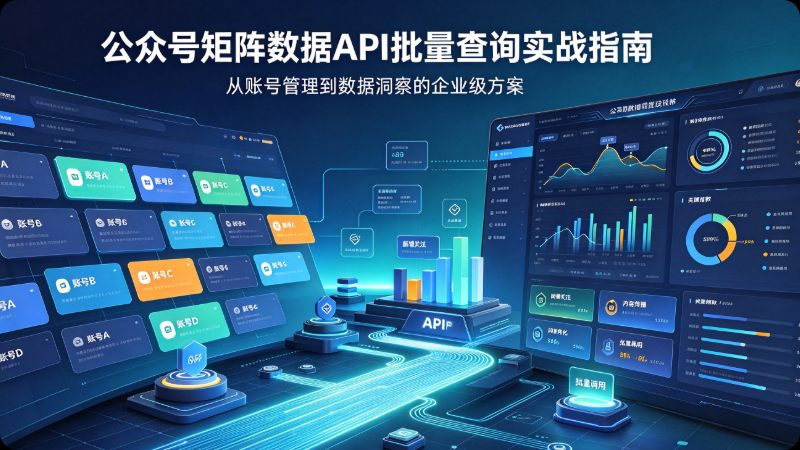
API批量查询解决的是三个核心问题:效率、历史、结构化。通过一次请求传入多个公众号标识,接口批量返回阅读数、点赞数、在看数、发文列表、文章标题、发布时间等字段,数据直接落库,可以按天、按周、按月做趋势分析。对于矩阵账号的历史数据,API还能回溯查询超过30天的文章数据,弥补官方后台的短板。这也是越来越多矩阵团队把“公众号矩阵数据API批量查询”列为技术选型必选项的原因。
二、批量查询能拿到哪些数据
一个实用的矩阵数据API,通常覆盖以下维度:
账号维度:公众号名称、微信号、头像、简介、认证信息、预估粉丝区间等基础画像。
文章维度:文章标题、链接、发布时间、阅读数、点赞数、在看数、评论数、是否原创、是否删除。
历史维度:按时间范围批量拉取历史发文列表,支持近5年数据回溯,解决官方后台30天限制。
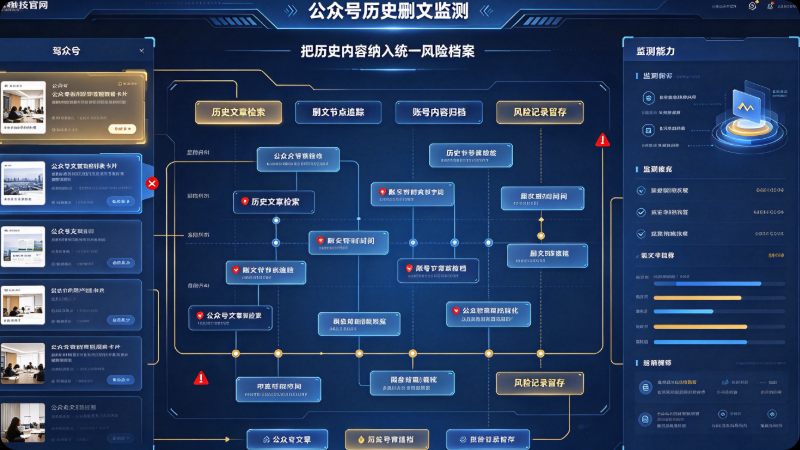
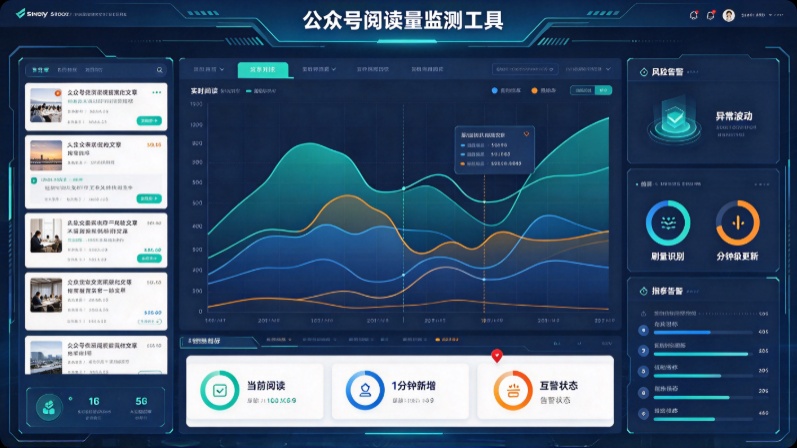
监测维度:分钟级阅读量变化曲线,用于识别刷量异常;删文监测,记录文章从有到无的状态变化。
关键词维度:按关键词批量搜索公众号文章,用于竞品监控和选题挖掘。
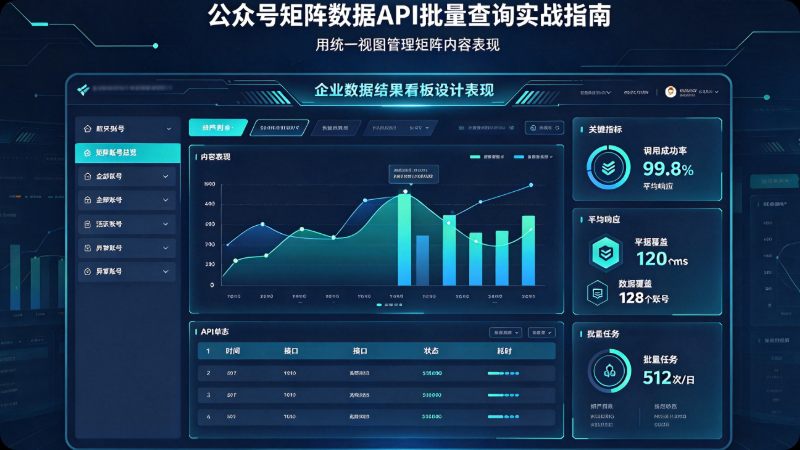
把这些字段通过公众号矩阵数据API批量查询一次性取回,比逐个账号抓页面稳定得多,也更适合接入内部BI看板或企业微信机器人。
三、接口调用的基本思路
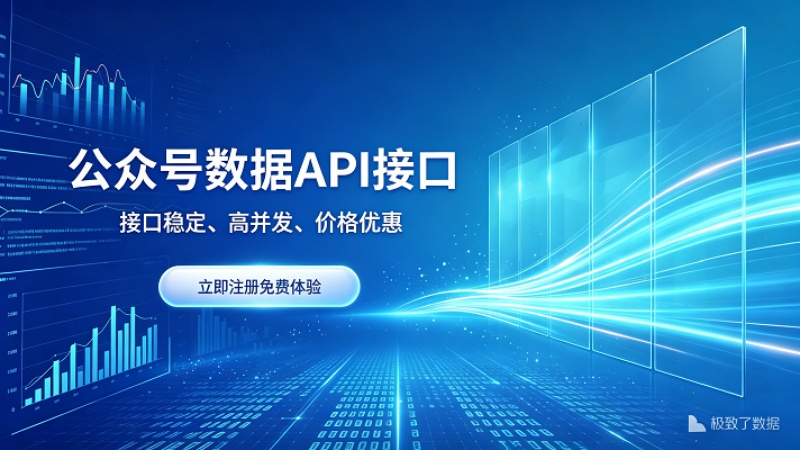
不同服务商的接口协议略有差异,但批量查询的通用逻辑一致:认证 → 传参 → 分页 → 落库 → 调度。
以典型RESTful接口为例,请求中通常包含:
appid/secret:身份认证;account_ids:公众号ID列表,支持数组批量传入;start_date/end_date:查询时间范围;page/page_size:分页参数,批量场景下建议单页50~100条;fields:指定返回字段,减少冗余数据。
返回结果一般是JSON结构,包含文章列表和分页信息。技术同学可以用Python快速封装:
python
复制
下载
import requests

url = "https://api.example.com/v1/wechat/matrix/articles"
params = {
    "appid": "your_appid",
    "secret": "your_secret",
    "account_ids": ["acc_001", "acc_002", "acc_003"],
    "start_date": "2025-01-01",
    "end_date": "2025-01-31",
    "page": 1,
    "page_size": 100
}
resp = requests.get(url, params=params, timeout=10)
data = resp.json()
for article in data["list"]:
    print(article["title"], article["read_num"], article["publish_time"])
实际落地时要注意三点:频率控制(避免触发限流,批量任务建议错峰调度)、增量更新(按发布时间增量拉取,不要每次全量)、失败重试(网络抖动时记录失败账号,下一轮补查)。把这三件事做好,公众号矩阵数据API批量查询才能稳定跑在每日定时任务里。
四、四个高频落地场景
场景一:矩阵账号日报自动化。 每天上午9点,定时任务调用批量查询接口,拉取矩阵内所有账号昨日发文和阅读数据,写入数据库后自动生成日报,推送到企业微信。运营不用再逐个后台截图,管理层也能看到矩阵整体阅读走势。
场景二:刷量异常识别。 结合分钟级监测接口,对矩阵账号和竞品账号的阅读曲线做批量对比。如果某篇文章在凌晨出现陡增、阅读与点赞比例明显偏离历史均值,系统自动打标提醒。批量查询让这种监控从“抽查”变成“全量覆盖”。
场景三:竞品爆文追踪。 用关键词批量搜索接口,每天定时查询竞品矩阵的发文列表,按阅读数排序,发现超过阈值的热文自动入库。选题会直接看数据,不再凭感觉。
场景四:历史数据补全与删文存档。 官方后台数据只保留30天,但投放复盘、年度总结、合规存档都需要更长周期。通过公众号矩阵数据API批量查询按季度回溯历史文章,同时记录删文状态,形成团队自己的数据资产。
客户案例:众享科技的矩阵集中管理实践。 众享科技运营多个企业公众号,此前面临登录切换频繁、数据统计割裂、素材选取低效等问题。使用极致了助手后,实现了多公众号批量集中管理、三天免扫码、多维数据统计(违规数据、流量主收入等)、低粉爆文素材搜索、账号云端同步与一键原创标记,矩阵运营效率明显提升。这一案例也说明,矩阵运营的核心是把账号、数据和素材集中到统一系统里管理,而公众号矩阵数据API批量查询正是实现数据集中化、自动化的关键能力。
五、选API服务时看什么
市面上的数据接口不少,矩阵批量查询场景建议重点看四点:批量能力(是否支持多账号一次传入、单次返回条数上限)、历史深度(能否回溯超过30天甚至数年)、稳定性(接口可用率、限流策略、文档是否清晰)、合规性(数据来源是否公开合规、是否支持企业级合同与发票)。对于需要长期做矩阵数据资产的团队,接口的稳定性和历史回溯能力比“免费”重要得多。
极致了提供的公众号数据API接口,覆盖矩阵账号批量查询、历史文章回溯、分钟级监测、删文监测和关键词搜索等方向,支持JSON返回和分页批量拉取,适合接入内部看板或自动化日报系统。如果你正在为矩阵数据采集搭架子,可以先用小批量账号跑通调用流程,再逐步扩大监控范围。
结语
公众号矩阵数据API批量查询不是技术炫技,而是矩阵运营从“人肉看后台”走向“数据驱动”的第一步。把批量查询接口接进定时任务,把返回数据落成自己的历史库,把异常监控和竞品追踪交给系统,团队才能把精力放在内容判断和策略调整上。先跑通一个最小闭环:选3~5个矩阵账号,调通一次批量查询,落库一天数据,再逐步扩展到全矩阵和历史回溯。这个闭环跑通之后,矩阵运营的数据底座才算真正建立起来。