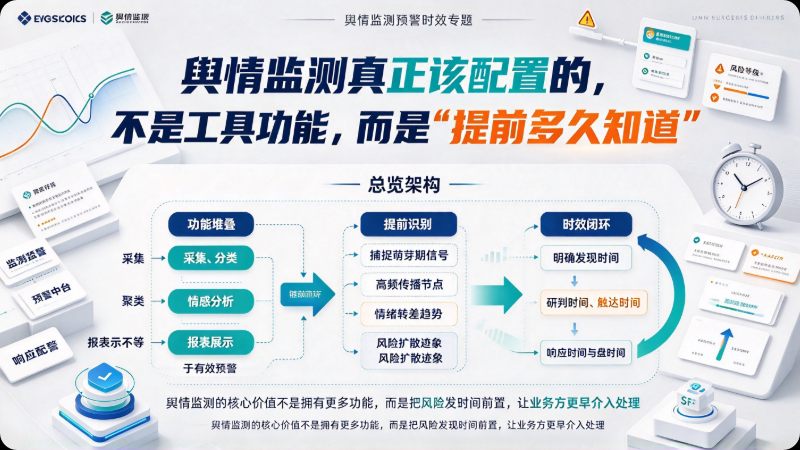
舆情监测真正该配置的,不是工具功能,而是“提前多久知道”
引言:极致了数据把舆情“怎么做”讲透了,但没讲“提前量该买多少”
翻一遍 极致了数据上关于舆情监测的内容,覆盖面已经相当完整:关键词布控怎么设、爬虫和 API 怎么选、情感分析和传播路径怎么用、公众号评论区的一二级评论怎么采集、竞品预警规则怎么从账号清单跑到第一条有效规则、节假日期间的非结构化内容和黄金时间问题怎么应对。这些文章回答的是“舆情监测有哪些动作,每个动作怎么做”。
但它们共同绕开了一个更前置、也更影响投入产出比的问题:你做这些动作,到底是为了在负面爆发之前“提前多久知道”? 如果一套系统配置齐全、预警天天响,但真正有用的信号总是在热搜已经起来之后才被注意到,那它买到的只是“事后知情”,不是“提前量”。反过来,一个只覆盖核心词、只盯少数重点账号的轻量配置,如果恰好卡在风险升级之前发出了一条可行动的信号,它创造的提前量可能超过一个功能更全但噪音淹没一切的系统。
本文把这个视角收束成一个核心关键词:风险提前量。
一、风险提前量的定义:从“信息出现”到“你还能做点什么”之间那段可用的时间
风险提前量指的是:一条风险信号从首次出现在可监测范围内,到它进入不可逆的传播升级阶段之前,你所拥有的、可以用来做出有效动作的时间窗口。
它不等于“预警延迟”。预警延迟是技术指标,衡量的是系统从采集到推送的秒数或分钟数。风险提前量是决策指标:同样一条预警,推给一个没有预案、不知道谁该接手的人,提前量接近于零;推给一个已经预先定义了“什么级别、谁响应、第一句话说什么”的团队,提前量才真正存在。乐思基于5000个真实案例的量化研究给出了一个参照:73%的危机在发生后4小时内达到传播峰值,每延迟1小时应对,总传播量平均增加23%;超过8小时未回应,危机进入“自我强化”阶段,此后需要3倍努力才能达到相同效果。2026年的数据进一步收紧了这个窗口:舆情从发酵到引爆的平均时间比2024年缩短了65%,快消行业的平均处置窗口仅3小时。
所以,风险提前量不是“越早越好”的抽象愿望。它有具体的长度、具体的场景和具体的成本。舆情监测的配置问题,本质上是把有限的预算和注意力,分配到不同风险场景所对应的提前量需求上,而不是均匀地铺在所有功能上。
二、现有内容缺的那一层:按“风险场景”配置提前量
极致了数据的舆情文章是按“方法”和“产出”组织的:关键词是一种方法,API 是一种方法,实时预警是一种产出,口碑分析是另一种产出。这种组织方式对学习工具很有用,但它不回答一个运营负责人最需要回答的问题:我的品牌面临的风险不是同一种东西,我凭什么用同一套监测配置去覆盖它们?
按风险提前量的逻辑,舆情风险至少可以拆成四种性质完全不同的场景,每一种需要的提前量长度和监测配置截然不同。
场景一:已知的已知——品牌名被直接提及的负面
这是关键词监测最擅长的场景:品牌名、产品名、高管名与“欺骗”“虚假”“翻车”“避雷”等负面词共现,系统触发预警。这个场景需要的提前量是小时级,配置重点是敏感词的覆盖精度和推送的即时性。极致了数据的文章已经把这个场景讲得很透,包括阈值设定(如同一话题一天内新增50条讨论触发飞书预警)和评论区二级回复的扩散信号识别。
但这个场景有一个容易被忽视的提前量损耗:关键词配宽了信息泛滥,配窄了漏报,而词表如果不随业务和舆论环境持续迭代,敏感词的命中率会随时间衰减。一个去年有效的负面词表,今年可能已经漏掉了用户正在使用的新表达。风险提前量在这里的敌人不是技术延迟,而是词表老化。
场景二:已知的未知——账号在“还没提你名字”时已经在积累风险
这是关键词监测的结构性盲区。一个账号连续三条内容都在影射某个品牌却不点名,一个渠道商账号突然开始抱怨供货问题,一组账号用不同文案在同一时间段发布指向同一件事的内容——这些在关键词监测里都不会触发,等它们终于带上品牌名,传播往往已经越过了最值得干预的阶段。
这个场景需要的提前量是天级,配置重心从“内容”转向“账号”。账号监测回答的是关键词监测回答不了的三件事:谁在说、他之前说过什么、他和谁一起在说。一个账号的发布频率突然偏离基线、互动中位数突然抬升、内容从日常转向集中指向某一主体,这些行为变化比单条内容的声量更有预警价值。极致了数据的竞品监测文章已经触及了账号清单的分层逻辑(直接竞品、替代品、行业媒体、KOL),但它的目标是“竞品动态”,而不是“风险主体”。把同一套账号分层思路平移到风险监测上,在关键词命中之前,用账号的行为节奏来购买提前量,是这个场景的配置核心。
场景三:未知的未知——AI 生成的、不指向具体关键词的虚假叙事
2026年舆论环境的一个结构性变化是:AI 让虚假信息的制造和伪装成本急剧下降。38%的企业曾遭遇 AI 编造的负面信息,这些信息可能是一段伪造的高管言论、一张移花接木的图片、一篇看似专业的“测评”,而且一旦被大模型抓取,即使原始内容被删除,仍可能在用户提问时被重新引用。这类风险的特征是:它可能根本不包含你的品牌名,也不符合任何已有的负面词模式,关键词监测和账号监测都可能漏过。
这个场景需要的提前量无法精确量化,但它需要的配置性质不同:从“匹配已知模式”转向“识别异常模式” 。多模态全域监测、AI 水军账号特征沉淀、批量同质内容的集群异常互动预警,都是这个方向上的动作。极致了数据目前的内容覆盖了短视频和评论区的情绪识别与话题聚类,但还没有把“AI 生成的虚假叙事”作为一个独立的监测对象来讨论。这是现有内容矩阵中一个真实的缺口,也是风险提前量配置中最需要“用异常检测换时间”的场景。
场景四:已知的即将发生——发布会、大促、节假日等可预判的高风险窗口
国庆、315、新品发布、高管直播——这些时间点的风险不是“是否发生”,而是“什么时候以什么形式出现”。极致了数据的国庆舆情文章已经触及了这个场景的难点:数据分散、非结构化内容占比高(2025年62%的舆情以视频、音频等非文字形式产生)、黄金时间极短。但这个场景的配置逻辑和日常监测有本质区别:日常监测购买的是“发现”的提前量,高风险窗口购买的是“预置响应能力”的提前量。
这意味着在这个场景下,监测配置的重心不是扩大关键词覆盖,而是提前定义好“什么信号触发什么预案” 。比如发布会期间,直播间弹幕和评论区的一级、二级回复需要以分钟级频率轮询,敏感信号一旦出现,对应的客服话术、澄清素材、 escalation 路径已经在手边。提前量在这里的形态不是“更早知道坏消息”,而是“坏消息到来时,动作已经在弦上”。
三、一个立刻能做的“提前量审计”:你的预警,有多少真正转成了动作
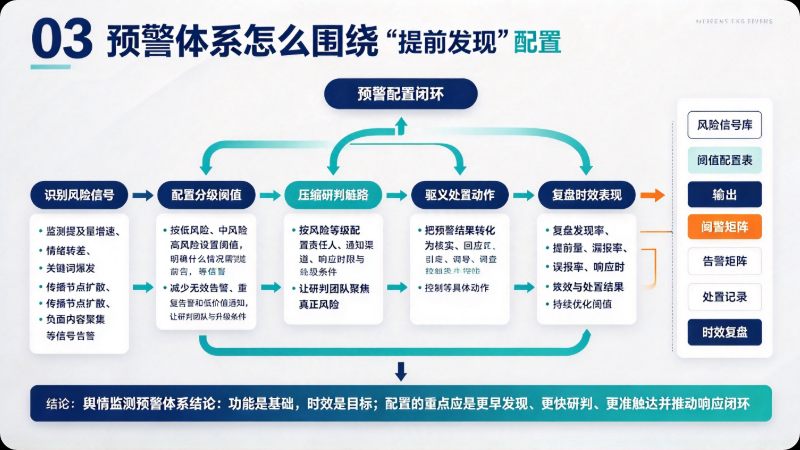
如果只带走一个可执行的动作,不是去增加关键词或升级套餐,而是打开你现有的预警记录,做一次风险提前量审计:过去一个月触发过的预警中,有多少条在被看到之后,确实触发了一个事先定义好的动作?
极致了数据的一篇文章里有一个值得注意的判断:预警失效有三种形态——太多(词表宽、阈值低,注意力被噪音耗尽)、太晚(推给了不常看后台的人,或只在工作时段推,夜里攒到第二天)、太粗(只推链接和“检测到负面”,没有量级、平台权重和建议动作)。这三种形态本质上都是同一个问题:预警没有绑定动作,提前量在“收到”和“行动”之间蒸发掉了。
审计的结果通常会指向两类调整。第一类,砍掉“有预警、无动作”的配置。 一个每天推送竞品阅读日报的规则,如果团队看完只是“知道了”,选题会上从不引用它做决定,它就不创造任何提前量,只消耗注意力。第二类,给每一条保留下来的预警规则补上“动作声明” :这条预警触发时,谁在什么时限内做什么。没有动作声明的预警,不应该占用推送通道。
风险提前量的配置,最终不是技术问题,而是注意力和响应能力的分配问题。工具可以做到分钟级采集、跨平台覆盖、AI 情感分析,但它做不了一件事:决定哪些信号值得被一个人的注意力接住,以及接住之后第一句话说什么。极致了数据已经把“采得到、推得出”做成了基础设施;下一步的增量,是把监测配置从“功能清单”翻译成“每个风险场景需要多长的提前量,以及谁来兑现这段提前量”。