公众号矩阵批量运营怎么做?先换逻辑,再搭四层结构
做公众号矩阵批量运营,最常见的起点是一口气注册三五个号,然后把同一篇文章改个标题挨个分发,或者给每个编辑分一个号,每天开会死磕阅读量。这样跑几个月,爆款没出来,账号倒先变成了僵尸号。
问题不在执行力,在底层逻辑。单账号是钓鱼逻辑,矩阵是织网逻辑。 钓鱼的时候,你要找最好的钓位、调最香的饵,无比渴望一条大鱼来支撑全部收益。但织网的时候,你不需要和某一条特定的鱼死磕,你要做的是顺着水流的方向,把不同深度、不同区域的鱼群系统性地拦截下来。出爆款是偶然的,系统性的流量拦截才是矩阵真正要追求的东西。
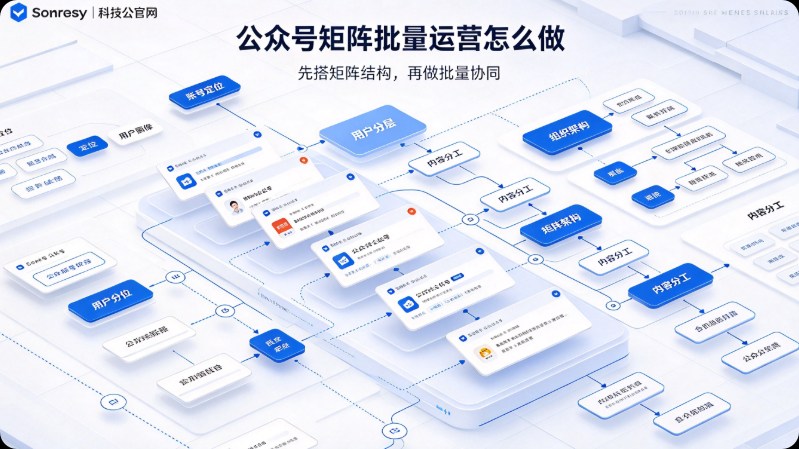
所以,“批量运营”的“批量”,不是指批量复制,而是指批量管理一套有分工的结构。这个结构至少包含四层:账号怎么分层、内容怎么差异化、数据怎么批量看、风险怎么提前防。
第一层:账号分层,先定角色再定数量
矩阵出问题的第一个信号,往往是账号之间没有分工。五个号都在讲同一个行业、同一类话题,结果不是覆盖更多人群,而是内部流量互搏。
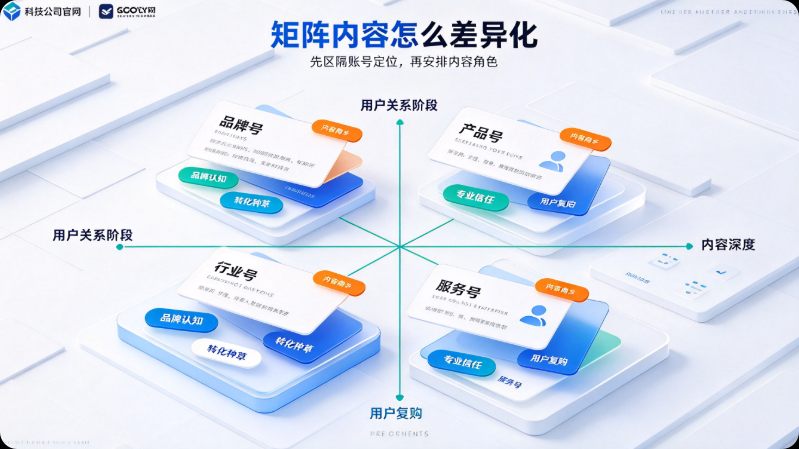
跑得通的矩阵通常采用“1 拖 N”结构:一个主号承担深度内容和信任沉淀,矩阵号分别承接不同的细分需求或不同阶段的用户。以职场赛道为例,主号讲行业大势和深度判断,矩阵号可以分别切简历面试、职场人际关系、新人情绪树洞——占据不同的生态位,用不同的切口去承接不同的搜索和阅读需求。
在角色功能上,账号至少分成两类:流量型账号负责拉新,追热点、降门槛、扩大触达面;信任型账号负责沉淀,只发硬核干货,阅读量可能不高,但粉丝极其精准,是转化的底盘。矩阵的底层公式可以粗略概括为:盈利能力 =(细分领域数 × 账号数量)× 人均产值 × 变现路径,单领域至少 3 个账号形成包围(主号 + 子号 + 备用号)是一个常见的参考基线。
先把每个号“本分”写清楚,再决定开几个号,比先注册一堆号再找内容填,要少走很多弯路。
第二层:内容差异化,批量不等于原样分发
矩阵批量运营最容易踩的坑,是把“同源素材复用”做成了“原样批量分发”。
平台的识别机制已经不再只比对文字重复率,而是通过内容指纹,综合画面、音频、行文逻辑做多维度判定。即使所有账号都是你自己运营的,原样批量分发依然会被判定为低质重复分发,引发流量限制,甚至牵连关联账号。同源素材复用本身是正常运营方式,平台并不禁止,重点是不能直接原样分发。
可执行的差异化做法是“母版 + 变量”:一份原始素材,在分发前产出多个差异化版本。文字层面可以更换表达视角——同一个探店选题,主号讲整体体验,分支号单独拆套餐、门店环境或顾客常见疑问;结构层面可以重构段落顺序;视频层面可以调整剪辑节奏、更换背景音乐或重新配音。同时错开各账号的发布时间,不要固定在同一分钟集中推送。简单换封面、改几个词,已经很难绕过当前的识别模型。
第三层:数据批量监控,矩阵的眼睛不能靠手动
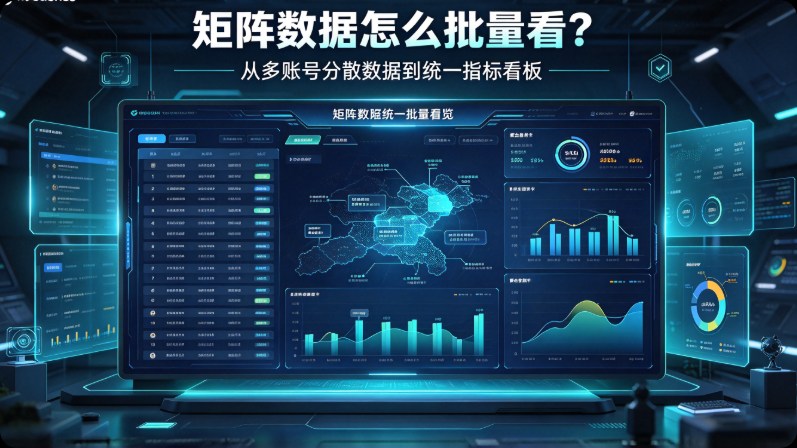
账号铺开之后,手动翻后台会迅速变成矩阵运营的效率瓶颈。十个号、每个号每天看一遍阅读和互动,一小时就没了,而且看到的只是零散数字,形不成对比。
批量监控需要把数据从“后台里看”变成“拉出来统一看”。以极致了数据的路径为例,接入后可以批量获取矩阵账号和竞品账号的文章标题、发布时间、阅读量、点赞、在看、分享、收藏等字段,支持近 5 年历史推文回溯,覆盖 90% 以上活跃公众号。接入方式按团队技术能力分两条:技术团队通过 API 直接拉取结构化 JSON,支持并发调用,采集 20 个公众号的数据,串行需要 10 秒,5 路并发只需 2 秒左右;运营人员则可以用飞书“多平台数据采集助手”插件,输入公众号名称即可采集并写入多维表格,配合定时任务自动更新,不接触代码也能跑通。
批量数据的价值不在“看谁发了什么”,而在于横向对比和趋势识别。把矩阵内所有账号的阅读量、分享率、互动率放进同一张表,才能快速看出哪个号在上升、哪类选题在多号同时跑量、哪个账号的数据开始持续低于基线。矩阵的调整依据,应该来自这张对比表,而不是单个账号后台的孤立数字。
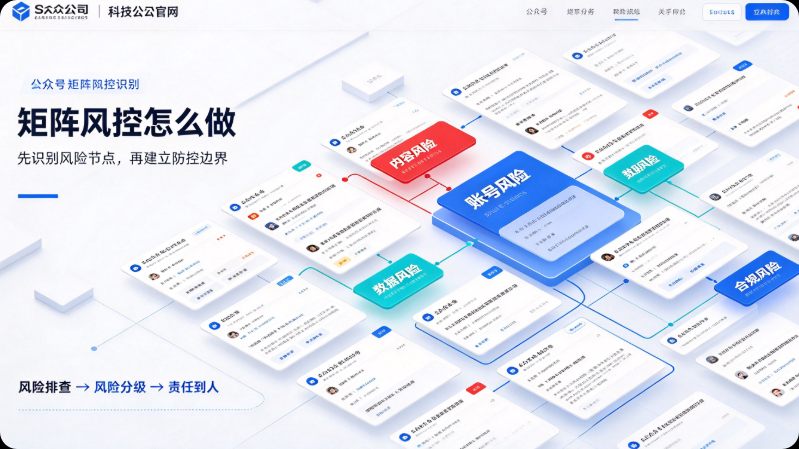
第四层:风险防控,矩阵越大,风控越要前置
矩阵运营的风险不是“会不会遇到”,而是“什么时候遇到”。平台对批量行为的识别维度在收紧,几个常见的触发点值得在搭建阶段就纳入规范。
同源内容原样分发是第一道坎,处理方式如上所述,建立差异化改造的常态化流程。账号关联是第二道坎:多个账号长期共用同一设备、同一网络来回登录,容易被平台标记为关联账号,重复内容带来的限流会更加明显。矩阵规模上去之后,设备和网络环境的隔离需要提前规划,而不是等限流发生了再补救。
自动化内容与发布是第三道坎。微信《运营规范》明确禁止脱离真实创作者表达的 AI 生成、改写、拼接内容,以及通过脚本、程序托管批量连续发布。轻则单篇流量限制或删除,重则账号功能受限甚至封禁。矩阵批量运营的效率工具应当用在数据采集、监控和协同管理上,而不是替代真实创作和人工判断。AI 可以用来辅助选题筛选、数据清洗、报表生成,但内容的表达主体和发布决策必须保留在真人手里。
一个可以直接执行的自查顺序
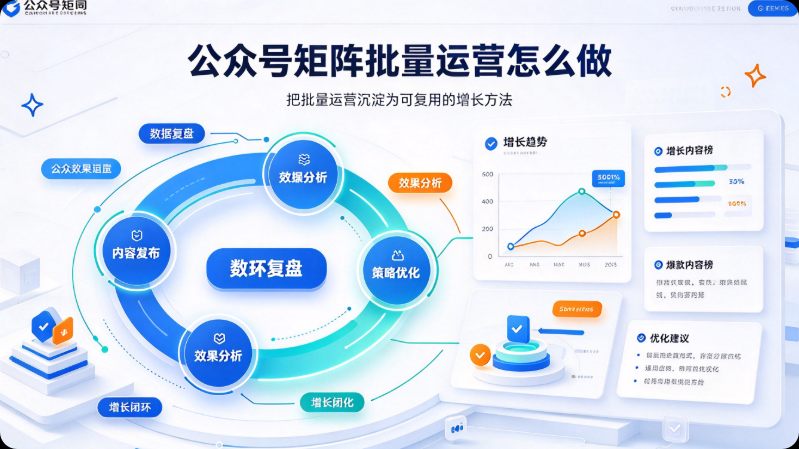
如果现在手里已经有一组矩阵号,按下面四步做一次体检,比继续加号或加发稿量更有效。
第一步,画一张账号角色表。 每个号写清楚:定位是什么、承担流量还是信任、服务哪一类细分需求。如果有两个号的定位无法用一句话区分开,优先调整角色,而不是继续加内容。
第二步,抽查最近 10 篇分发内容。 看同源素材在不同账号之间的差异度:标题、视角、段落结构、配图是否有实质性区别,发布时间是否错开。差异度不足的,先停掉原样分发,把差异化改造纳入发布前的固定检查项。
第三步,把数据拉进同一张表。 用 API 或飞书插件批量采集矩阵账号的核心指标,按周做横向对比。重点关注持续低于基线的账号和持续跑量的选题方向,让资源向有效的位置集中。
第四步,检查设备和网络环境。 多账号是否存在高频交叉登录,是否需要做环境隔离。矩阵的风险防控成本,永远低于出事之后的恢复成本。
矩阵批量运营真正的门槛,不在“能不能同时管很多号”,而在有没有一套让多个号各司其职、互相导流、数据可批量读、风险可提前防的结构。主号的文章末尾自然带出矩阵号的引流点,流量号的菜单栏和自动回复直接链向信任号的干货集锦,一次偶然进来的读者,通过不同账号的内容被反复清洗和沉淀,最终留在自己的基本盘里。这张网织好了,流量是顺着结构流进来的,而不是靠某一天某一条内容突然爆发。