矩阵数据怎么批量看?把后台数字拉进同一张表
公众号矩阵批量运营铺开账号之后,效率瓶颈会迅速从“写不出来”转移到“看不清楚”。
五个号、八个号,每天挨个打开后台看阅读量、点赞、在看,一小时就过去了。更麻烦的是,你看的是一堆孤立的数字:这个号今天 3000,那个号 2500,但没有横向对比,你不知道 3000 对这个号来说算好还是算差,也不知道某个号的分享率是不是已经连续一周低于矩阵基线。
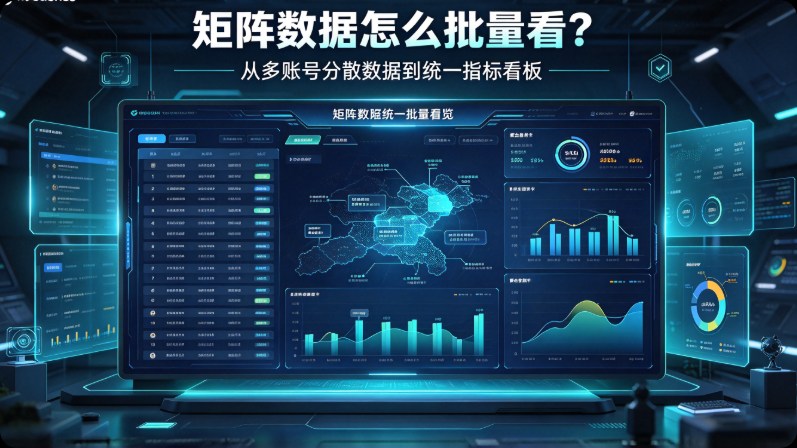
矩阵的数据价值不在单个账号的绝对值,而在对比和趋势。要把这个价值释放出来,第一步是把数据从各个后台“拉出来”,放进同一张表。
两条路径:技术团队走 API,运营团队走插件
批量数据采集的路径选择,取决于团队有没有开发资源,而不是取决于哪个工具“更高级”。
有技术团队的,走 API 直连。以极致了数据的公众号 API 为例,接入后可以批量拉取矩阵账号的文章标题、发布时间、阅读量、点赞、在看、分享、收藏等字段,支持近 5 年历史推文回溯,并发调用可以显著压缩采集时间。数据返回结构化 JSON,直接写入自己的数据库或 BI 系统,后续做看板和告警都在自己的控制范围内。
没有开发资源的运营团队,走飞书插件更务实。在飞书安装“多平台数据采集助手”插件,批量导入矩阵账号名单,选择要统计的指标(阅读量、涨粉、点赞、在看、分享等),设置每日自动同步,数据直接写入多维表格。矩阵整体和分账号的数据在同一张表里呈现,运营人员不需要接触代码,也不需要每天手动记录。
如果矩阵同时跨公众号、视频号、小红书等多个平台,则要考虑统一的矩阵管理工具。新榜矩阵通这类产品支持多平台账号的集中纳管和数据自动汇总,适合账号分布超过两个平台、且需要统一看板的团队。MaxHub API 则覆盖公众号、视频号、搜一搜三端,适合以微信生态为核心、需要跨端数据的场景。
表里放什么:基础字段决定能不能“看问题”
数据拉进同一张表之后,字段设计决定了这张表有没有诊断能力。
基础字段至少包括:账号名称、发布日期、当日发文篇数、总阅读量、平均阅读量、点赞、在看、分享、涨粉/掉粉。这些字段回答“谁在什么时间表现如何”。
进阶字段用来回答“为什么”和“接下来怎么办”:单篇最高阅读(识别爆款能力)、粉丝来源结构(搜索、推荐、其他,判断流量健康度)、内容类型标签(哪类选题在多号同时跑量)。矩阵的调整依据——砍掉哪个方向、把资源压到哪类内容上——应该来自这些字段的交叉对比,而不是来自某一天某个号的孤立读数。
看数据的节奏:日报、周对比、月复盘
批量数据最容易犯的错,是“拉了一张大表,然后没人看”。
有效的节奏是三层:每日看异常——有没有账号数据骤降、连续掉粉、发文中断,这类信号需要当天推送提醒,它们有时也是账号关联风控的早期信号;每周做横向对比——把矩阵内所有账号的阅读、分享、互动放进同一张表排序,看哪个号在上升、哪个号持续低于基线;每月做结构复盘——调整账号定位和资源分配,决定下一个月的母版方向。
其中,分享率和互动率的横向对比尤其值得单独看。矩阵的批量分发很容易把阅读量做上去(如果账号有关注基础),但分享率骗不了人:多个账号的同源内容如果分享率同时走低,说明内容差异化的程度不够读者感知到的是“重复”而不是“不同价值”。数据在这里充当的是内容策略的验证器,而不只是结果记录。