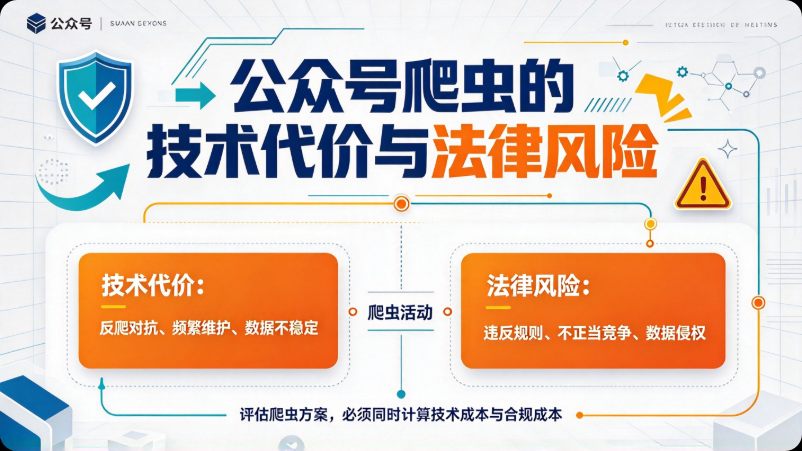
公众号爬虫的技术代价与法律风险
所属主题:公众号数据采集全景指南 · 对应章节:第2节 三种方案对比
自建爬虫在理论上提供了最大的灵活性:不受接口权限约束,可以触及任何公开可见的页面。但这一灵活性由两项代价支撑:持续的技术维护投入,以及2025年之后显著上升的法律风险。将这两项代价纳入决策,是判断“自己写爬虫是否划算”的前提。
核心判断
爬虫的问题不在于“技术上做不到”,而在于维护成本的非线性增长与法律定性的清晰化同时发生。微信反爬机制持续升级,IP封禁与接口失效需要专人长期维护代理和解析规则,短期可用的脚本在数月尺度上大概率失效。与此同时,《反不正当竞争法》第十三条将“避开或破坏技术管理措施”作为独立的规制要件,指导性案例262号进一步明确了数据集合经营性利益的保护边界。爬虫的技术代价和法律风险不再是可以分开评估的两件事。
一、技术代价的真实量级
爬虫的维护不是“写完就能跑”的一次性工程。反爬升级要求持续的规则适配,代理池的连通率和切换开销在高频采集下成为固定成本,单机架构在规模上升后需要向分布式演进。这些投入在竞品账号数量较少时可能被低估,但随着监控范围扩大,人力占比会持续挤压数据本身的价值产出。
二、法律风险的定性变化
2025年之前,数据爬取的争议多依赖反法第二条的原则性条款裁判;第十三条生效后,“是否绕开技术措施”成为可独立认定的违法性要件。公众号平台设置了robots.txt和登录态等技术措施,爬虫绕过这些措施的行为本身,即使采集量不大,也已经落入第十三条的规制射程。叠加262号案“实质性替代”的认定逻辑,爬虫采集的数据如果被用于构建替代性阅读或搜索产品,不正当竞争的认定风险会进一步上升。
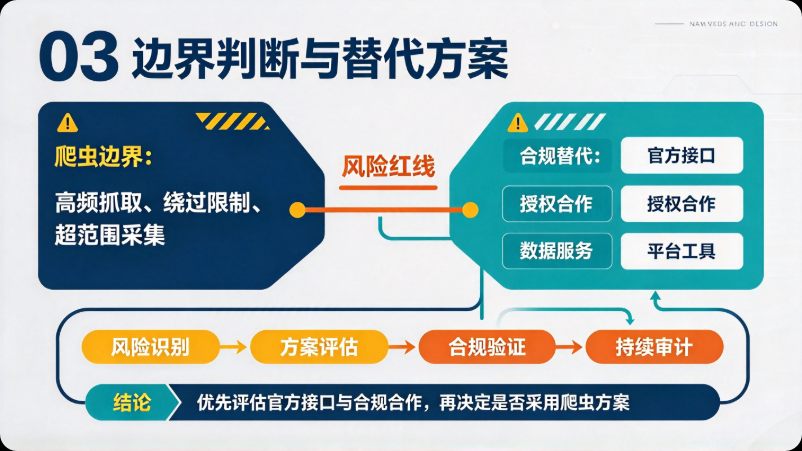
回到全景框架:自建爬虫是支柱页第2节中“以维护成本和法律风险换取理论灵活性”的一极。当维护投入与合规不确定性同时存在时,第三方合规API的中间定位才显示出意义。接下来可阅读第三方合规API的选型标准与来源审查,了解如何在一个不完美的中间路径上做出可辩护的选择。