飞书零代码公众号采集的适用边界
所属主题:公众号数据采集全景指南 · 对应章节:第4节 接入形态
不是每一个需要公众号数据的团队都有开发资源。飞书零代码方案解决的是一个具体的组织问题:运营人员需要将竞品公众号数据汇入一张可筛选、可对比、可定时更新的表格,但没有技术人员来写API调用代码。理解这一方案的适用边界,比比较插件功能更有实际意义。
核心判断
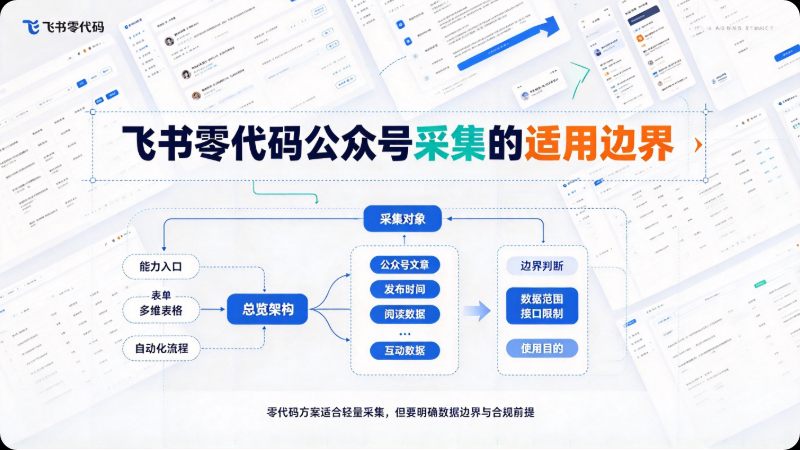
飞书零代码采集的实质是将API调用能力封装为多维表格内的操作体验:在飞书应用市场安装“多平台数据采集助手”后,输入公众号名称或配置竞品清单,插件在后台调用接口,将数据写入表格并支持定时任务更新。它消除了开发门槛和手动截图劳动,代价是字段范围、触发逻辑和批量能力由插件封装决定,无法像API直连那样自由定制。
一、零代码方案真正解决什么
定期竞品监控、周报数据汇总、多账号阅读量趋势观察——这些任务的共同特征是需要的是“持续汇总”而非“全量建模” 。零代码插件恰好覆盖这一区间:运营人员无需等待技术排期,配置完成后即可获得自动更新的结构化表格,把时间从手动扒数转移到分析本身。
二、什么情况下零代码不够用
当需求涉及非标准字段的批量拉取、写入飞书之外的系统(自有数据库、BI工具)、或复杂的触发条件时,插件封装的边界就成为瓶颈。此时API直连是必要的升级路径。零代码方案的合理定位是“日常汇总与轻量监控”,而非“全量数据管道”。将这一边界与团队的实际数据用途对齐,比追求“功能最全”更务实。
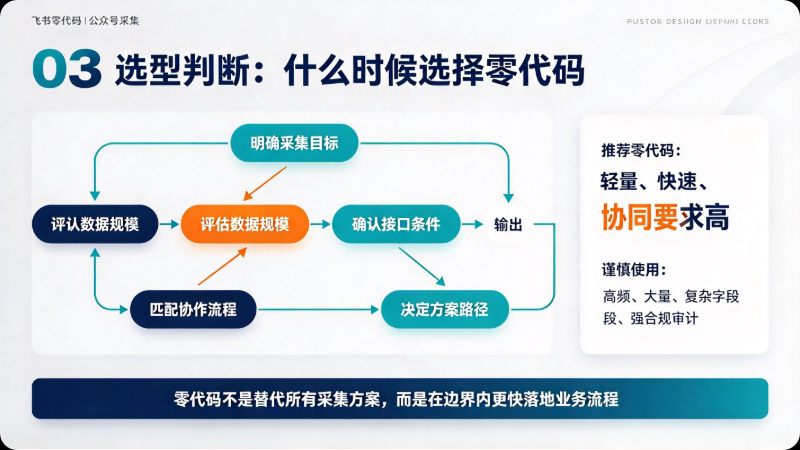
回到全景框架:飞书零代码方案是支柱页第4节接入形态中“最低技术门槛”的一极。它让数据采集从开发任务变为运营任务,但数据来源的合规审查并不会因为操作界面变得简单而消失。接下来可阅读公众号数据采集的合规审查与合同落地,将前述所有判断收束为可执行的审查与采购动作。