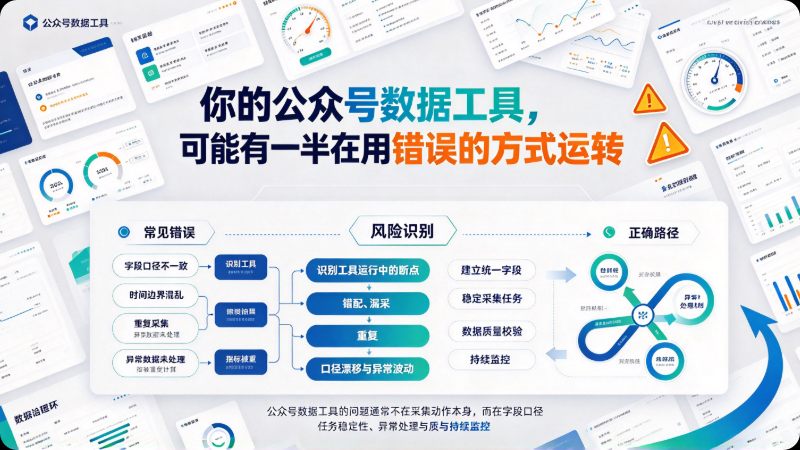
你的公众号数据工具,可能有一半在用错误的方式运转
极致了数据上不缺关于数据的文章。选题挖掘的文章告诉你怎么用搜索词、爆文和评论区三类数据源找到题目;阅读量诊断的文章教你先查竞品最近7天的高阅读,再判断是选题偏离还是标题没接住;竞品监控的文章讲清了分钟级推送和飞书预警的配置方式;API 接入的文章把50个数据方向和并发调用的细节铺得很开;数据采集的三条技术路径那篇,甚至把官方API、开源自部署和MCP协议的选型边界都画了出来。这些内容各自成立,放在一起却漏掉了一个更前置的问题:你的运营节奏,到底需要哪一档数据能力,以什么频率、什么形态介入?
工具越堆越多,决策带宽反而越窄,这不是公众号运营独有的困境。2026年的一项行业调查中,约七成数据负责人认为自己的工具栈已经过于复杂,超过一半计划在一年内做整合。公众号运营者面对的版本更具体:一边是分钟级监控、低粉爆文、API批量抓取、飞书自动推送这些能力摆在面前,一边是每天真正能用来“看数据、做判断”的时间并没有变多。问题很少出在“缺工具”,而在于数据能力与决策节奏之间没有对上。
选题阶段要的是“验证信号”,不是“实时流”
极致了数据的选题挖掘文章已经讲清楚了三类数据源:搜索词、爆文、评论区。但有一件事没有被展开:这三类数据在什么时间介入,决定了它们是有效信号还是噪声。
如果你在选题会上打开分钟级监控,看到竞品刚刚发布的一篇文章阅读量在快速爬升,第一反应很可能是“这个题我也要跟”。但分钟级数据在选题阶段提供的信息,本质上是一个正在发生的热度,而不是一个被验证的需求。热度可能在两小时后回落,也可能来自一次性的渠道推荐,选题决策如果建立在这类信号上,追的是波动,不是方向。
更匹配选题阶段的数据形态,是低粉爆文和已完成传播周期的高阅读样本。极致了数据收录的低粉爆文,筛选逻辑是“低粉高阅读”——粉丝基数不大,阅读量却显著超出账号常态,这说明内容触发了超出粉丝基本盘的传播。这个信号比分钟级的阅读爬升更慢,但它回答的是选题阶段真正需要回答的问题:这个题目在没有大号加持的情况下,有没有被真实需求推动过。
同理,竞品的高阅读文章如果是一条孤立峰值,前后迅速回落,它在选题上的参考价值远低于一条连续上升或持稳在高位的内容。前者可能是标题或封面的单次胜利,后者才可能指向一个持续存在的需求缺口。选题阶段把分钟级监控推到后台,把低粉爆文和历史传播曲线放到前面,不是降低数据能力,而是让数据能力的频率与决策的频率对齐。
分钟级监控的真正用武之地,不在“盯选题”,在“抓拐点”
那分钟级监控是不是被高估了?恰恰相反。它的价值在另一个决策节点上被严重低估了:传播过程中的异常拐点识别。
一篇内容发布之后,阅读量的增长通常有一个可预期的斜率。极致了数据的 API 支持1、2、5、10分钟四档频率,输出的是阅读、点赞、在看的原始增量序列。这意味着你看到的不是“现在有多少阅读”,而是“每5分钟新增了多少阅读”。当一个原本平缓的增量序列突然出现陡升,那才是值得立即介入的信号:可能是某个社群发生了二次传播,可能是被推荐流命中了,也可能是一个负面评论正在引发连锁反应。
这时候分钟级数据的作用不是帮你“决定写什么”,而是帮你决定此刻要不要做点什么——要不要追加分发、要不要在评论区回应、要不要让客服准备话术。选题决策的周期是天,传播干预的周期是分钟。把两者放在同一个数据面板里管理,结果就是选题时被实时流干扰,传播时又拿不到足够细的增量信号。数据能力的配置问题,首先是决策周期的匹配问题。
把数据“推给人”和“嵌进流程”,是两种完全不同的能力
极致了数据提供了飞书插件和API两条路径,现有文章也分别做了介绍:飞书插件零代码,适合运营人员直接使用;API灵活,适合接入BI系统或自定义推送。但如果只把它们理解为“技术门槛不同的两种接入方式”,就错过了更关键的区分。
“推给人”解决的是知道的问题,“嵌进流程”解决的是动作的问题。 一条飞书预警告诉你竞品发了一篇阅读量异动的新文章,这是“推给人”。一个API把竞品的数据同步到你自己的内容决策表里,表格里同时有选题状态、发布排期和历史阅读基准,新数据进来之后自动触发一条规则:“该选题的竞品参照阅读超出你近30天均值2倍,建议在排期表中上调优先级”——这是“嵌进流程”。
大多数运营团队的数据工具停在“推给人”的层面,然后抱怨“预警太多、看不过来”。2026年关于数据工具整合的讨论中反复出现的一个判断是:仪表盘的堆积之所以制造疲劳,是因为它们主要服务于回顾,而不是嵌入决策。公众号运营的数据能力配置,同样需要从“加一个推送”转向“减一次判断的中转”。飞书多维表格之所以在运营场景中被频繁使用,恰恰因为它同时承载数据、协作和动作状态,数据落在哪里,决策就在哪里发生,不需要在“数据面板”和“工作流”之间来回搬运。
按“决策节点”配数据,而不是按“功能清单”配工具
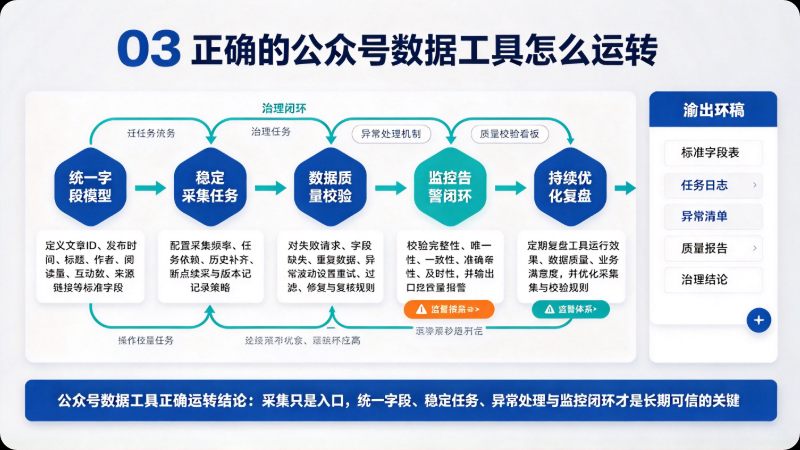
把上述逻辑收拢,极致了数据的能力矩阵其实可以按运营的四个决策节点重新组织,而不是按功能名称罗列:
选题验证节点,匹配的是低粉爆文、历史高阅读样本和竞品传播曲线。数据频率以天为单位,形态是可对比的参照系,而不是实时流。传播监测节点,匹配的是分钟级增量序列和评论区关键词预警。频率以分钟到小时为单位,形态是拐点信号,触发的是干预动作而不是选题动作。工作流嵌入节点,匹配的是API和飞书多维表格直写。频率跟随发布节奏,形态是数据回流到决策表,让每一条新数据自动落到一个已有的动作位置上。周期校准节点,匹配的是历史回溯和跨账号对比。频率以周或月为单位,形态是基准线的更新,回答的是“我的判断标准需不需要调”。
这四个节点不需要四套工具。它们需要的是同一套数据能力在不同频率和形态上的分配。极致了数据已经具备覆盖这四个节点的底层采集能力,缺的不是功能,而是一个让运营者看清“什么节点该调用什么”的配置视角。
先停掉一个“没有决策跟着走”的数据动作
如果只带走一个可执行的动作,不是去注册一个新功能,而是打开你现有的数据配置,找到一个每天在看、但看完之后没有任何决策跟着走的数据项,把它停掉或降频。
可能是一个每天推送的竞品阅读量日报,你看完只是“知道了”,但选题会上从来不引用它。可能是一个实时监控面板,你打开的频率和你做干预的频率完全对不上。停掉它,不是放弃数据能力,而是把判断带宽还给那些真正有动作等在后面的数据信号。
工具的价值不取决于它采集了多少,而取决于它介入的时刻是否恰好是决策发生的时刻。公众号运营的数据能力配置,到了该按节奏重新排一次的时候了。