公众号运营周报自动生成——从“手动翻后台”到“数据自己走进协作界面”
周报本身不产生价值,周报所消耗的时间才产生机会成本。公众号后台不提供导出,运营人员每周要逐页翻看阅读、分享、完读、渠道构成,再手工复制粘贴到文档或表格中。这个过程的技术含量不高,但它占用的恰好是“可以用来分析数据、调整选题”的那段时间。
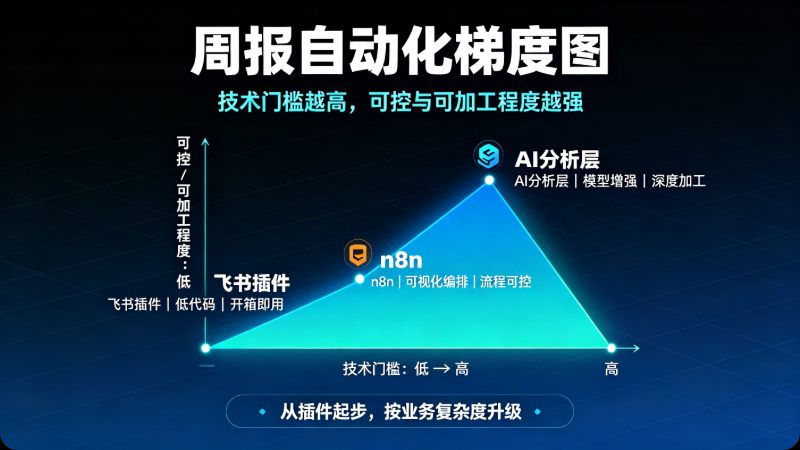
自动生成周报的核心命题不是“把数据写成文字”,而是让数据在没有人工搬运的情况下,出现在团队已经在使用的协作界面里。飞书、n8n、Coze等工具在2026年已经形成了从“零代码”到“全自动”的完整梯度。这篇文章按“最小闭环 → 稳定运行 → 深度加工”的顺序,把自动周报的落地路径拆清楚。
1. 先跑通最小闭环,再谈自动化深度
分钟级监测的隐性成本不在工具采购,而在数据到达之后的摩擦。如果一个流程需要人工登录、截图、粘贴,即使数据是1分钟级的,实际使用频率也会迅速衰减。周报自动化同理:第一优先级是让数据自动出现在飞书或钉钉的表格里,而不是先追求“报告写得漂亮” 。
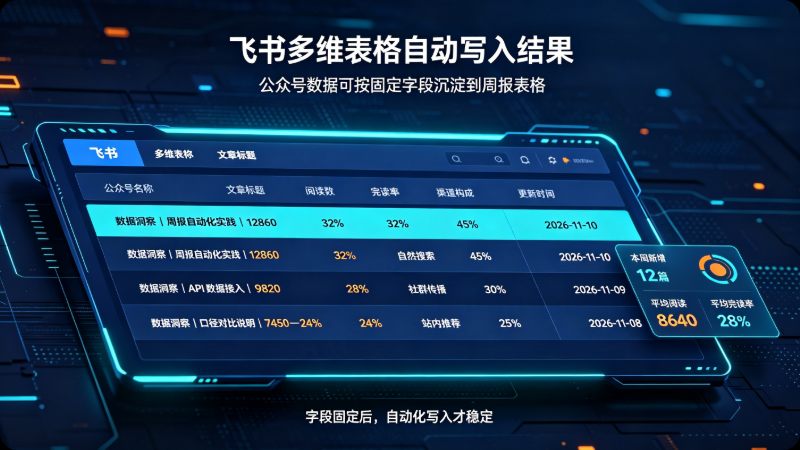
最稳妥的起步方式是飞书插件零代码方案。在飞书应用市场安装“多平台数据采集助手”插件,选择“公众号”平台,输入公众号名称(支持多个),设置定时任务,数据每日自动写入多维表格并支持推送到飞书群。这条路径不解决复杂的数据加工,但它能把运营人员从逐个登录后台的重复劳动中释放出来,定位是从“手动记录”到“自动同步”的过渡层。有用户用它同时监控五个竞品公众号,每天定时同步,省去大量手动统计时间。
2. 当需求稳定后,迁移到n8n/API路径
飞书插件验证了“监测对象选对了、指标能支撑决策”之后,如果还需要多账号并行监听、自定义告警或二次计算,就需要迁移到更深的路径。n8n工作流是2026年被较多技术运营团队采用的方式,核心链路分四步:
第一步:准备biz参数。打开目标公众号任意一篇文章,F12搜索var biz,复制Base64字符串。注意浏览器复制出来的值可能带%3D转义,需要URL解码还原为==结尾再传入接口。
第二步:获取API Key,与biz配合使用。
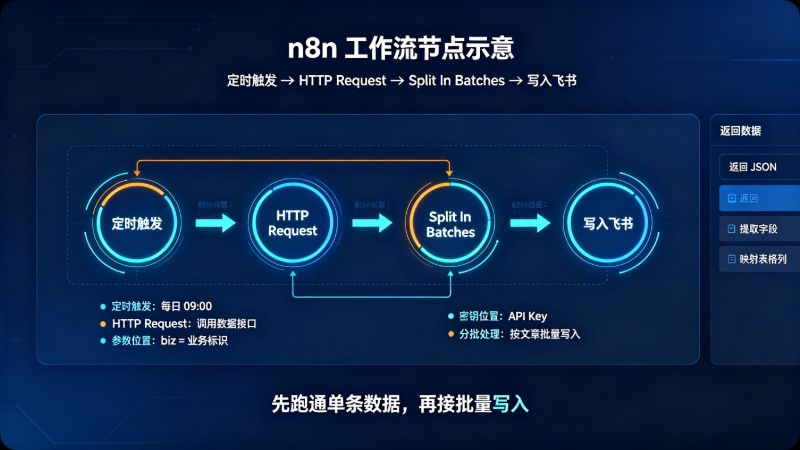
第三步:搭建n8n工作流:定时触发节点 → HTTP Request节点传入biz和API Key获取最新文章列表 → Split In Batches节点逐篇拆解 → 第二个HTTP Request节点请求文章详情 → 清洗后写入飞书文档或Notion。
第四步(可选):接入AI分析层,在数据落地后接入AI Agent做选题分析、自动简报或标签分类,形成“监听→采集→分析→沉淀”的链路。
一个实操中容易忽略的细节:存储文章链接时直接存RSS或Webhook返回的原始链接,不做二次跳转,可以避免追踪参数和环境验证带来的不稳定。
3. 周报的“内容”从哪里来:数据源决定报告质量
自动周报如果只汇总“阅读量、分享量、点赞量”,很容易变成一份“数字罗列”,对选题和策略的指导有限。周报的分析价值取决于数据源的深度。公众号后台的datacube提供文章级完读率、阅读率、送达PV,单篇渠道页提供逐篇阅读人数、平均时长和渠道构成(推荐 / 搜一搜 / 公众号消息等,30天窗口)。把这些维度纳入周报,才能回答“哪类选题的完读率在上升”“搜一搜带来的阅读占比是否在变化”这类问题。
另一个务实的设计是口径对齐放在周报文首。如果周报同时使用了发表列表(实时累计)、datacube(7天窗口T+1)和单篇渠道页(30天窗口)的数据,不标注口径的跨源比较会制造虚假的“增长”或“下滑”信号。mpdt的做法是在周报文首附完整口径说明,这个做法值得任何自动周报方案借鉴。
4. 不要跳过“验证阶段”
从飞书插件直接跳到n8n,最常见的后果是指标选错了、阈值设错了,复杂工作流改起来的成本比从头搭建更高。一个可操作的节奏是:阶段一(验证)用零代码插件跑通“数据到达表格” ,确认监测对象和频率合理;阶段二(稳定)将需要长期留存或二次计算的部分迁移到API/n8n,数据进入自有系统后做自定义告警和二次加工。Coze等平台上的“运营周报月报自动生成助手”也遵循同样的逻辑:先收集数据再生成,输出标准Markdown可直接用于飞书/钉钉文档,适合作为轻量级验证工具。
结论:公众号运营周报自动生成的可行路径是零代码飞书插件 → n8n/API → AI分析层的递进结构。起点越低,验证成本越小;迁移越晚,返工代价越高。周报的真正价值不在“自动”,而在“数据维度是否足够支撑决策”——只汇总阅读量的自动周报,和手动翻后台没有本质区别。