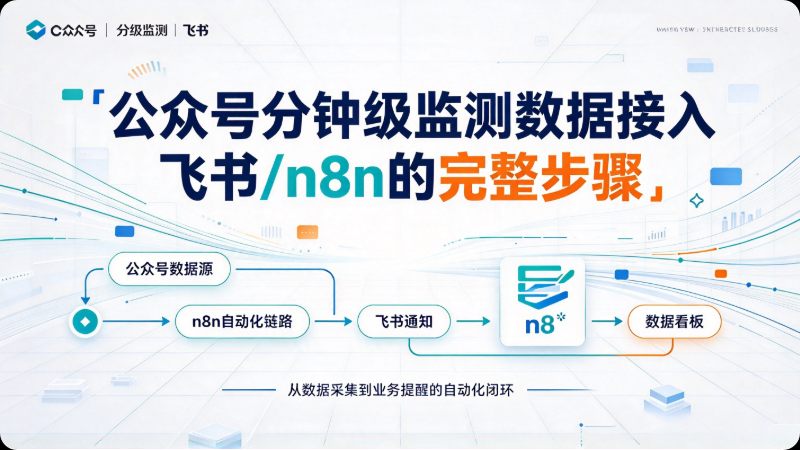
公众号分钟级监测数据接入飞书/n8n的完整步骤
1. 核心原则:先跑通最小闭环,再谈自动化深度
分钟级监测的隐性成本不在工具采购,而在数据到达之后的摩擦。如果一个流程需要人工登录、截图、粘贴,即使数据是1分钟级的,实际使用频率也会迅速衰减。接入策略的第一原则是:让数据自动出现在团队已有的协作界面里,而不是要求人去工具界面里找数据。
更稳妥的顺序不是一上来就搭复杂工作流,而是先用最低配置成本跑通“数据从公众号到达表格”,验证监测对象、频率和指标是否匹配实际工作流,再把需要长期留存或二次计算的部分迁移到更深层的路径。本文的接入步骤属于【公众号数据采集与监测的完整选型框架】中自动化接入层的落地部分。
2. 路径A:飞书插件(零代码,配置成本最低)
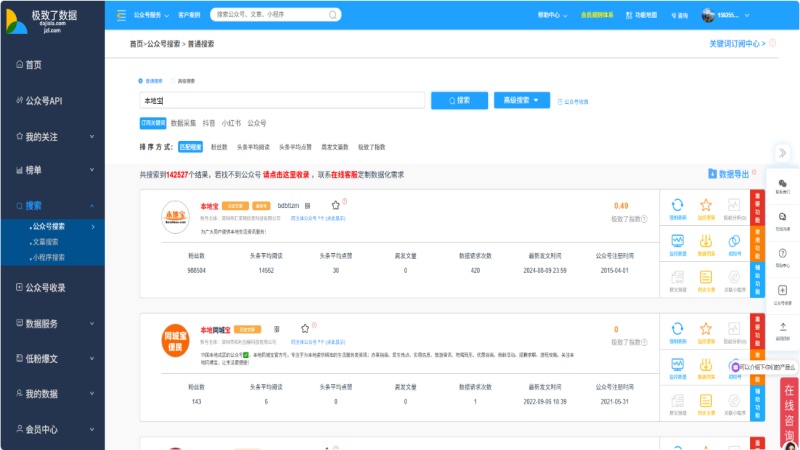
极致了数据在飞书应用市场提供“多平台数据采集助手”插件。安装后,在配置面板选择“公众号”平台,输入公众号名称(支持一次多个,逗号分隔),设置定时任务,数据每日自动写入多维表格并支持推送到飞书群。
这条路径的定位是从“手动记录”到“自动同步”的过渡层。它不解决复杂的数据加工需求,但能把运营人员从逐个登录后台的重复劳动中释放出来。有用户用它同时监控五个竞品公众号,每天定时同步,省去大量手动统计时间。
3. 路径B:n8n工作流(无人值守,多账号并行)
适合需要长期、多账号并行监听、且数据落地后还要继续加工的技术团队。核心链路分四步:
第一步:准备 biz 参数。 打开目标公众号任意一篇文章,F12搜索 var biz,复制那串Base64字符。注意从浏览器复制出来的值可能带 %3D 转义,需要先做URL解码还原为 == 结尾再传入接口。
第二步:获取API Key。 在数据服务平台注册获取,与 biz 配合使用。
第三步:搭建n8n工作流。 定时触发节点 → HTTP Request节点传入 biz 和API Key获取最新文章列表 → Split In Batches节点逐篇拆解 → 第二个HTTP Request节点请求文章详情 → 清洗后写入飞书文档或Notion。
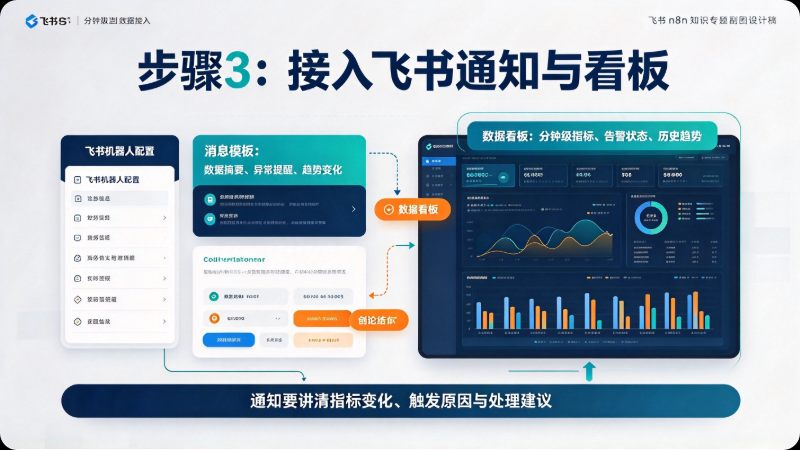
第四步(可选):接入AI分析层。 在数据落地后继续接入AI Agent模块,做选题分析、自动简报或标签分类,形成“监听→采集→分析→沉淀”的链路。
n8n路径的灵活性最高,但需要搭建和维护投入。一个实操中容易忽略的细节:存储文章链接时,直接存RSS或Webhook返回的原始链接,不做二次跳转,可以避免追踪参数和环境验证带来的不稳定。
4. 迁移路径:从飞书插件到API/n8n
不建议跳过飞书插件直接上n8n。更稳妥的节奏是:
阶段一(验证) :飞书插件,零代码,跑通“数据到达表格”。确认监测对象选对了、频率合理、指标能支撑决策。
阶段二(稳定) :当流程稳定、需求明确后,把需要长期留存或二次计算的部分迁移到API直接对接或n8n工作流。API路径的优势是数据进入自有系统,可以做自定义告警和二次计算,不受工具界面限制。
跳过阶段一的典型后果是:指标选错了、阈值设错了,复杂工作流改起来的成本比从头搭建更高。如果还在犹豫是否值得从插件迁移到API,可先【回到支柱页查看按场景选型的对照表】确认自己的需求层级。
迁移前建议先确认数据源精度,【选择数据源前的SaaS与API精度对照】给出了偏差范围。