新榜、西瓜数据与API路径的精度对照与选型
1. 核心差异:估算值 vs 官方口径字段
新榜、西瓜数据、清博等SaaS平台的数据,相当一部分是通过技术手段估算的,不是从微信官方直接返回的真实值。有运营者做过对照实验:拿新榜显示的阅读量与自有后台真实数据比较,偏差少时10%,多时达到30%以上。
而合规API路径返回的是与官方后台口径一致的结构化字段,基本没有这类系统性偏差。这不是“谁更准”的问题,而是数据生产方式的区别:一个是估算模型输出,一个是原始字段交付。
2. 30%的偏差在什么场景下会变成实际问题
偏差本身不必然导致错误决策。问题在于,某些决策场景对偏差的容忍度远低于其他场景。
容忍度较高的场景:快速了解一个行业有哪些活跃账号、大致排什么位置、头部号的分布轮廓。新榜的账号收录量和榜单积累在这些场景下效率很高,偏差不影响“方向感”。
容忍度极低的场景:
- 竞品归因:看到竞品某篇阅读量突然上涨,判断“这个选题爆了”并跟风投入。如果上涨来自估算波动而非真实传播,跟进决策就建立在虚假信号上。
- 刷量识别:需要分钟级原始增量序列来判读曲线形态。如果曲线本身来自估算数据,判读的可靠性会大幅下降。
- 对外汇报:领导发现你引用的预估粉丝数与另一来源差了几倍,数据来源的可信度会被连带质疑。
3. 三个平台的精度画像与定位差异
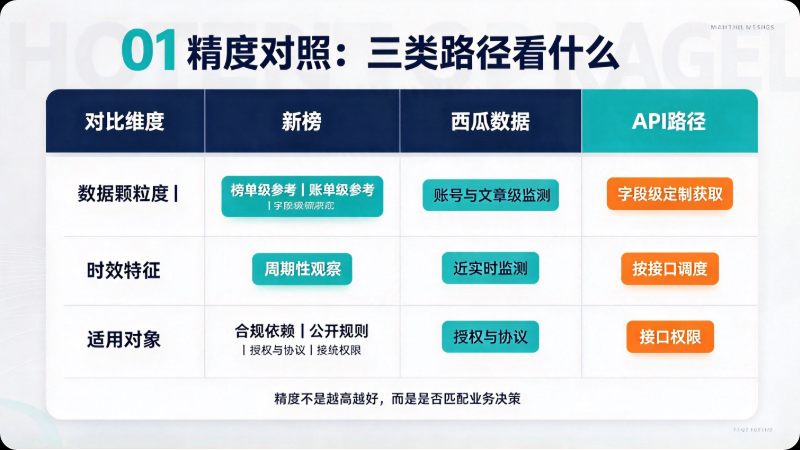
| 平台/路径 | 数据性质 | 更新节奏 | 核心适用场景 | 精度提示 |
|---|---|---|---|---|
| 新榜 | 技术估算 | T+1为主 | 行业概览、账号收录广度、榜单参照 | 阅读量偏差10%—30%+ |
| 西瓜数据 | 技术估算 | T+1为主,部分分钟级 | 投放筛选、达人评估、刷量初筛 | 侧重商业投放维度 |
| 清博 | 估算 + WCI指数 | 每日两次,T+1 | 政务/企业品牌监测、传播力评估 | WCI是综合指数,非原始字段 |
| 合规API | 官方口径字段 | 分钟级可选 | 精确竞品对照、自动化管道、刷量核验 | 基本无系统性估算偏差 |
清博的WCI指数是一个需要单独理解的对象:它是对阅读数、点赞数、在看数等指标做对数标准化后合成的评估指数,适合横向比较账号传播力,但它本身不是原始数据,不能替代对单篇文章真实增量的核验。
4. 选型判断:不是“二选一”,而是“分层使用”
SaaS平台和API路径的关系不是替代,而是观测层与管道层的分工。
用SaaS做“面” :快速扫描一个行业有哪些号值得关注、大致处于什么量级、榜单结构如何。这一步的效率优势是API路径不具备的。
用API做“点”和“线” :对已经锁定需要精确监测的账号(竞品、投放对象、自有矩阵),用官方口径字段建立数据管道。“点”是单篇的精确互动数据,“线”是分钟级增量序列——这两类需求是估算平台的结构性盲区。
一条可执行的判断规则:如果你的下一步动作依赖于“这个数字是否真实”,就值得为这部分数据切换到API路径;如果下一步动作只是“知道大概方向”,SaaS的效率和成本优势更合理。