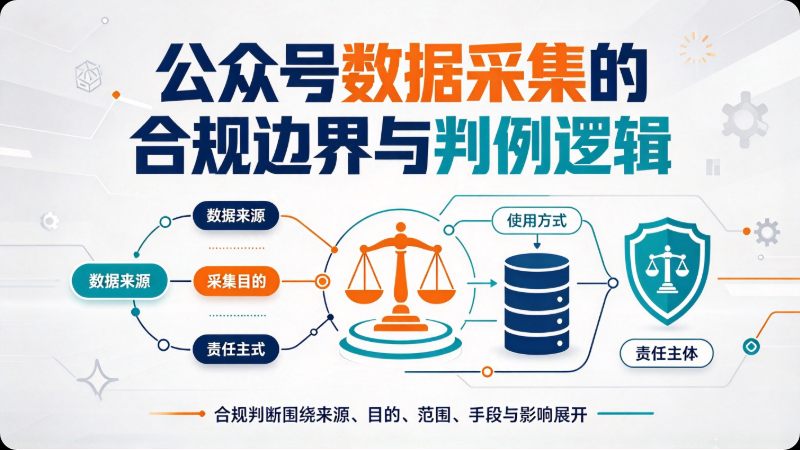
公众号数据采集的合规边界与判例逻辑
1. 一个正在收窄的边界
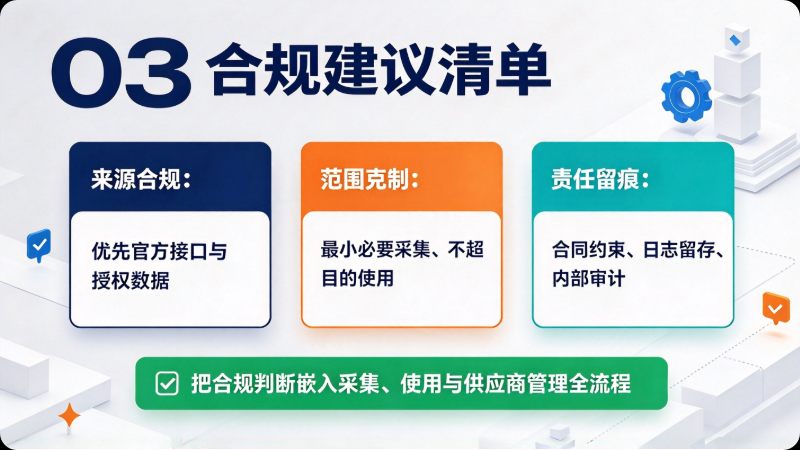
公众号数据采集的技术方案已经非常成熟,GitHub上的相关项目不下二十个。但合规边界正在快速收窄。2025年深圳中院的一个判例把红线划得很清楚:绕开技术保护措施的自动化采集,即便不涉及用户隐私,也可能构成不正当竞争。本文把【公众号数据采集与监测的完整选型框架】中的三条合规原则落到判例和场景判断上。
2. 判例拆解:三条红线各自对应什么行为
该案中,被告用爬虫抓取公众号文章数据(含阅读数、点赞数),搭建搜索和排行网站并通过广告变现,法院判赔60万元。判决逻辑可以拆成三层:
第一层:平台对“数据池”享有竞争性权益。 微信公众平台积累的整体数据资源具有商业价值,不能未经授权批量取走用于商业目的。
第二层:绕开技术保护措施本身构成妨碍。 IP访问限制、封禁机制、反自动化脚本不是摆设,绕过它们就是在破坏规则,这一点不以“数据是否公开可见”为转移。
第三层:实质性替代平台功能。 被告的产品功能取代了平台自身提供服务的能力,导致用户分流。注意关键词是“实质性替代”——不是“用了数据”就侵权,而是你的产品变成了平台功能的替代品。
3. 场景判断:技术可行不等于场景可行
三条红线的实操含义可以压缩为一句话:合规性取决于场景,不取决于技术难度。
- 个人学习或内部研究:不走商业化、不替代平台功能,风险可控。控制请求频率(sleep不低于10秒),采集后尽快退出登录。
- 团队内部长期分析:在开源方案基础上封装监控和重试机制,做好数据使用管控,确保数据仅限内部使用、不对外分发。
- 商业化产品:唯一稳妥的路径是走官方API或合规数据服务商。把采集到的数据包装成公开服务卖出去,风险极高。
4. 2026年的两个新增注意点
扫码登录的账号风险。 技术社区反复提示:如果需要扫码登录,账号可能被服务方用作“号码池”中的一份子,面临封号风险。闭源扫码付费产品中,这种模式并不少见。
AI/自动化替代真人操作的平台规范。 微信公众平台运营规范明确,不得利用AI、脚本、接口或其他自动化方式替代真人完成内容创作、发布等流程。采集本身与“替代发布”是两件事,但在设计工作流时需要避免让自动化越界到内容发布环节。合规判断需要与采集路径、使用场景一起看,可【回到支柱页查看按场景选型的对照表】中的“商业化产品”一行。
| 官方API覆盖不到竞品时,可选路径见【官方API覆盖不到竞品时可选的三条采集路径】。 |