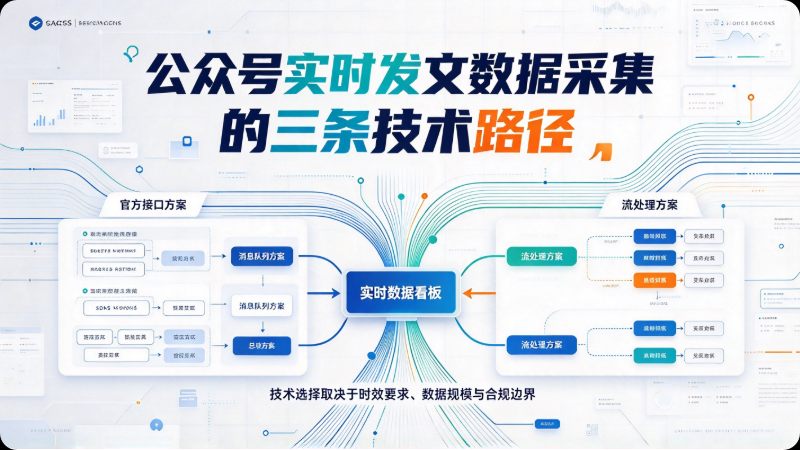
公众号实时发文数据采集的三条技术路径
1. 一个必须先认清的事实:官方API管不了竞品
很多技术选型的起点是“先看微信官方有没有接口”。有,但边界极其清晰:官方发布能力接口(如 freepublish/batchget)只能操作已授权给当前账号的内容,每日调用上限为100次,且2025年7月起个人主体和未认证账号的调用权限已被回收。更关键的是,已开启群发通知的内容不在该接口的返回范围内,竞品数据更是完全不提供。
这意味着一件事:如果监测对象包含任何一个不属于你自己的公众号,官方API路径从一开始就走不通。后续三条路径本质上都是在解决“官方API覆盖不到的那部分数据从哪里来”的问题。
2. 路径一:第三方合规API服务
以极致了数据为代表。数据不是通过用户端直接触碰微信接口获取,而是由服务商完成合规采集、清洗后,以标准化接口交付。对使用者来说,接入的是已经稳定运行的数据管道,而不是微信本身。
关键能力边界:
- 实时监控:支持1、2、5、10分钟四档频率,文章发布后以5—10分钟间隔更新阅读、点赞、在看,输出原始增量序列。
- 历史回溯:支持回采指定公众号的完整文章列表及内容,覆盖2000万以上公众号账号。
- 接入成本:注册获取API Key → 获取目标公众号的
biz参数 → 调用接口。biz是公众号的唯一标识,格式为一串Base64编码字符,不随改名或头像更换而变化。
适用判断:有明确监测对象(含竞品)、需要分钟级或定时数据、希望把精力放在数据使用而非采集维护上的团队。
3. 路径二:开源自部署
GitHub上的方案数量可观,但2026年的现实是路径收窄速度快于项目更新速度。曾经主流的公众号后台接口方案在2026年7月底被官方封禁,微信读书接口成为当前主要“活路”,但风控严格程度在持续上升——账号可能进入“风控中”状态,需等待数小时至数天解除,部分项目已出现归档或停维。
开源方案的真实成本不在代码,而在长期维护:接口漂移需要跟进、反爬策略升级需要适配、扫码登录存在账号被用作“号码池”的风险。有技术社区用户直言,闭源扫码付费产品中不少是在用用户的账号为付费用户服务。
适用判断:有专职技术维护能力、需求高度个性化、且能接受“项目可能在某次接口调整后需要自行修复”的组织。不适合作为生产级唯一数据源。
4. 路径三:MCP协议与AI工作流集成(2026年新变量)
2026年出现的新路径是将采集能力封装为MCP服务器,供Claude Desktop、Cline、Cursor等AI客户端直接调用。例如 cimi-data-mcp 提供 get_today_articles 工具,按次计费;wechat-download-api 也内置了MCP服务。
这条路径的价值不在“采集”本身,而在于省去数据从接口到AI工作流之间的搬运环节。如果你的终点是让AI直接读取公众号数据做分析,MCP路径比“先采集到数据库、再喂给AI”少一层工程。
5. 三路径对照与选型决策
| 维度 | 第三方合规API | 开源自部署 | MCP协议工具 |
|---|---|---|---|
| 数据来源 | 服务商合规采集封装 | 用户自行调用微信接口 | 底层数据源决定 |
| 竞品覆盖 | 支持 | 视项目能力,部分支持 | 视底层源 |
| 实时性 | 分钟级(1—10分钟) | RSS定时 / 实时模拟 | 视工具 |
| 维护责任 | 服务商 | 使用者 | 视工具 |
| 主要风险 | 服务商稳定性 | 接口漂移、账号风控 | 生态早期,稳定性待验证 |
决策规则:先确认监测对象是否包含竞品。不包含,官方API的100次日调用限额可能够用;包含,从路径一或路径二中选,路径三作为AI原生场景的补充。