公众号搜一搜关键词搜索量数据获取——官方不公开的“数”,到底怎么拿
搜一搜在公众号流量来源中的占比,已经从17%上升到了41.27%,垂直领域公众号30%到60%的新增粉丝来自搜一搜自然搜索。但一个让运营者反复卡住的现实是:微信官方并不公开完整的搜一搜关键词搜索量数据。微信指数给的是“趋势”,不是“量”;公众号后台能看到“哪些词带来了流量”,但颗粒度粗到无法支撑选词决策。这篇文章不讨论“怎么选词”,只回答一个更前置的问题:搜索量数据本身,从哪来,怎么拿,拿到的数据长什么样。
1. 先看清常规路径的边界在哪里
微信指数是最基础的入口。它整合了微信搜索、公众号文章和朋友圈公开转发行为,但本质是反映热度的指数,不是精确的搜索量数值,且只支持7日、30日、90日三个时间窗口。用它判断“一个词是否在升温”可以,用它决定“这个词值不值得做标题”,精度不够。
公众号后台的搜一搜模块能告诉你哪些关键词带来了实际流量,但数据维度有限,无法反向查询“一个尚未布局的词有多少搜索量”。第三方工具如5118、蝉妈妈可以辅助挖掘长尾词和竞争度,但搜一搜场景的专精度参差不齐。至于爬虫采集搜狗微信搜索,页面结构变动频繁,维护成本与合规风险都不低。
常规路径的共同短板是:它们回答的是“已经发生了什么”,而不是“用户正在搜什么、某个词的热度是多少” 。要拿到后一类数据,需要换一个思路。
2. 搜一搜数据的真正来源:下拉词与结构化采集
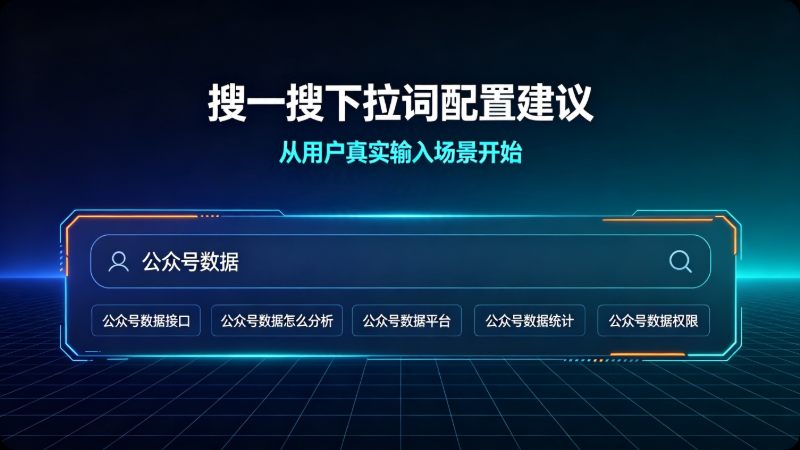
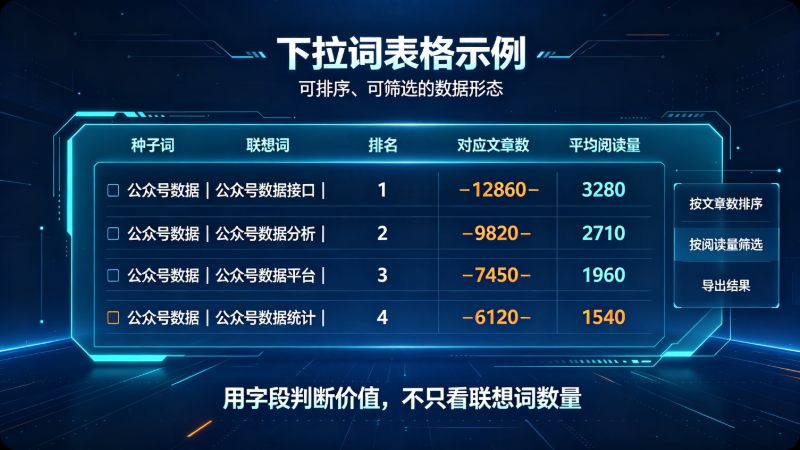
搜一搜搜索框的下拉联想词,是系统根据海量用户真实搜索行为动态聚合生成的。数据显示,68%的用户在输入2到3个字符时就会直接选择下拉菜单中的选项,下拉词的点击率比完整输入高出3到5倍。换句话说,下拉词不是“猜测”,而是用户用指尖投出来的需求排序。
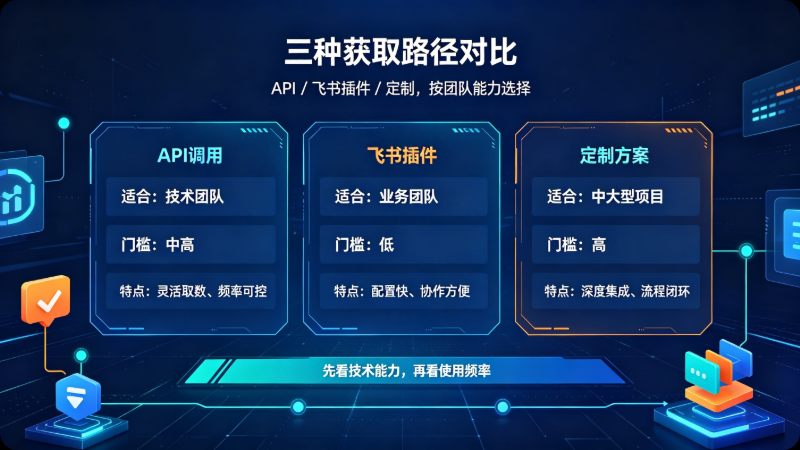
把下拉词从搜索框中“批量拽出来”,变成可排序、可筛选的结构化数据,是获取搜一搜关键词搜索量数据的核心路径。具体有三种落地方式,对应不同技术能力的团队:
API接口直连(有技术团队) 。在数据服务平台注册获取API Key后,通过搜一搜实时搜索接口传入种子关键词,返回的是结构化JSON,包含下拉词列表及对应的文章搜索结果。接口支持多路并发,二十个关键词几秒钟可以跑完,新增文章的收录延迟控制在10到30分钟。以DataXAPI的wechat.keywords.related接口为例,传1个词返回约10个联想词和名次,按次计费,失败不收费。
飞书插件零代码采集(不想写代码) 。在飞书应用市场安装“多平台数据采集助手”插件,输入种子关键词,下拉词和相关文章数据自动写入多维表格,并可设置定时任务自动更新。
客服定制数据表(两者都不想做) 。提供需求清单,由服务方按需交付现成的结构化数据表。
三种路径的实质相同:把“查一个数”变成“把用户真实的搜索行为提取出来,变成可批量处理的数据资产” 。
3. 拿到数据之后,真正需要注意的是“时间窗口”
搜一搜数据的一个隐性陷阱是数据断档。微信官方后台只保留30天的互动数据,过期即清空。这意味着如果你在季度末想回溯三个月前某篇文章的搜一搜来源构成,后台已经无法提供。数据获取方案是否支持近5年历史推文回溯,决定了你拿到的是“当下可用的词”,还是“可跨周期比较的词”。
另一个容易被忽略的维度是口径对齐。公众号后台的“发表列表”是实时累计口径,“datacube”是发表后7天窗口T+1口径,“单篇渠道页”是30天窗口口径——三源同名指标的分母和统计窗口各不相同。如果采集回来的搜一搜数据没有标注口径,跨源比较时就会出现“同一个指标,两个页面两个数”的困惑。
4. 数据到手后的第一步:做“可搜索性”判断,而非直接选词
拿到下拉词和搜索数据后,一个常见的误用是“哪个词量大就写哪个”。更务实的判断标准是两个数:该词条下的文章数量,以及这些文章的平均阅读量。文章数量少、平均阅读量高,是蓝海,优先切入;文章数量多、平均阅读量低,是红海,中小号挤进去投入产出比很低。一条可参考的通用线是:月搜索量大于800、竞争度小于70的词,优先级放高。
标题和前200字是搜一搜抓取的第一信号。下拉词采集回来之后,最直接的落点就是把高频长尾词自然写入标题和首段,而不是在正文中反复堆砌。
结论:搜一搜关键词搜索量数据获取的关键,不在于“有没有数据”,而在于数据是否结构化、是否可批量、是否覆盖足够长的时间窗口。API直连、零代码插件、定制交付三条路径分别对应不同技术能力,但共同的前提是把下拉词从搜索框里系统性地拉出来,变成可排序、可追溯、口径对齐的数据表。