公众号搜一搜下拉词批量采集
可以批量采,但采集本身不解决选词问题。 下拉词是用户正在输入什么,不是哪个词一定有流量;批量采集的价值在于把候选池从“手动输入的几十个”扩大到“系统化覆盖的几百上千个”,选词决策仍然需要你来做。
先接受一个事实:手动采集的极限是每天几十个词
一个做母婴辅食的运营者发了47篇原创,总阅读不到一万,不知道关键词该埋在哪。手动在搜一搜里逐条复制下拉词,一天能拿到的量级是几十个。而要做系统化的关键词布局,需要的候选池是几百甚至上千个。
这不是效率问题,是量级不匹配。
三条路径,按团队的技术条件选
API接口是长期最优解,前提是有开发资源。注册获取API Key后,调用搜一搜实时搜索接口,传入种子关键词,返回结构化JSON,包含下拉词列表和对应的搜索结果。五路并发采集二十个关键词只需要几秒钟。
RPA机器人适合没有开发资源、但需要批量采集几百个关键词的团队。5118和八爪鱼都有现成的微信下拉词挖掘机器人。以5118的RPA为例,在Excel输入表填好关键词,机器人自动完成搜索、抓取、写入,1分钟多可以获得20个搜索词的下拉词数据,词量总数达到178个。代价是维护成本:微信客户端更新或页面结构变化可能导致机器人失效。
飞书插件是零代码的日常采集方案。在飞书安装“多平台数据采集助手”,输入种子关键词,下拉词自动写入多维表格,支持定时任务。适合日常的周期性采集,不适合一次拉取上千词的大规模任务。
种子词的选择,直接决定采集结果的可操作性
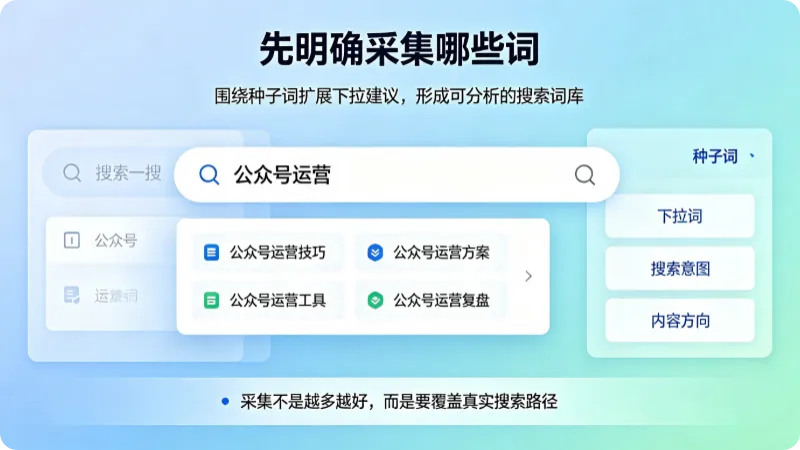
种子词越泛,下拉词的噪音越大。做职场内容用“职场沟通”而不是“职场”,做辅食的用“宝宝辅食做法”而不是“母婴”——发散出来的下拉词才更贴近真实的内容边界。
采集回来的下拉词,用两个维度做快速筛选:该词条下文章的数量(竞争激烈程度)和每篇文章的平均浏览量(流量上限) 。词少读高的是蓝海,词多读低的是红海,词少读也低的不值得碰。
下拉词不等于搜索量,这是必须守住的边界
搜一搜的下拉词按联想顺序排列,越靠前通常热度越高,但它不是精确的量化指标。批量采集解决的是“不知道用户搜什么”,不解决“哪个词一定能带来流量”。真正的选词决策还需要观察搜索结果页的供给情况——搜这个词出来的是什么内容、有没有大号占据、内容饱和程度如何。采集完下拉词之后,选词、竞品对照和监测怎么串起来,见〖下拉词采集之后,选词与监测如何串成一条线〗。
站内延伸:〖搜索关键词下拉词是否可以批量采集〗给出了API和飞书插件两条落地路径及选词框架;〖技术团队怎么批量采集公众号搜一搜下拉词〗补充了RPA方案的具体操作和三种路径的适用边界。