公众号数据诊断,从手动到自动的升级路径
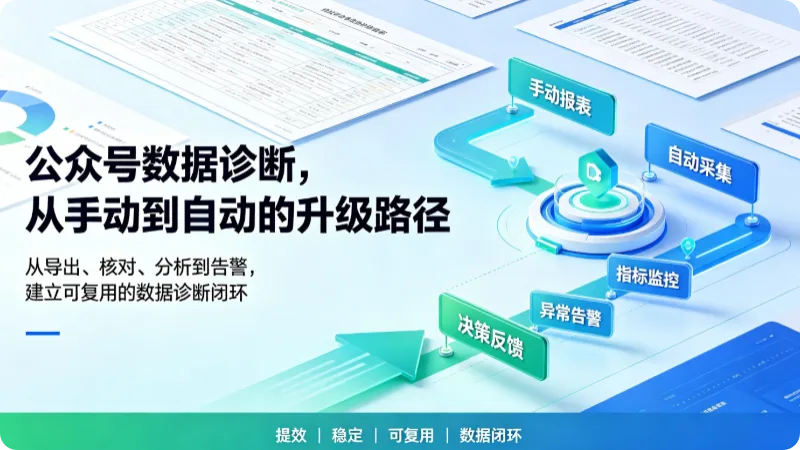
四个动作——看竞品、判曲线、拉趋势、采下拉词——卡住大多数运营者的不是“不会分析”,是“数据到手之前精力已经用完了”。 手动翻竞品、截图阅读量、逐条复制下拉词,这些动作的天花板不在方法,在一个人一次只能处理一个账号、一个时间点、一组有限的词。
手动路径的隐性成本:不是慢,是“只能做到这个深度”
手动获取数据有一个容易被低估的代价:它把你锁在孤立的快照里。你看到的是“这篇阅读量是多少”,但看不到“这篇的增量曲线长什么样、和上个月同选题相比在什么位置、互动比值有没有偏离基线”。
当竞品从2个变成5个,回看时间从30天拉到一年,种子词从3个扩展到20个,手动路径的边际成本几乎线性上升,而分析深度不会因为“更努力地翻”自动提升。
四个动作,对应四层数据能力的升级
竞品分析:从“翻标题”升级为“结构化对标”。 拿到的不是一堆文章标题,是一张带发布时间、互动字段、可切片对照的长表。近5年历史回溯补上了官方30天窗口之外的视野,判读的起点从“最近发了什么”变成“选题轨迹和互动数据的对应关系”。这套“从翻标题到结构化对标”的做法,完整操作见〖公众号竞品分析从翻标题到结构化的完整做法〗。
分钟级监测:从“盯数字”升级为“看形态”。 曲线是诊断工具,不是监控默认值。先有4—6周的基线,再用四种异常形态做标记,最后用三维交叉验证决定“标记”还是“定性”。低频做筛查,1—2分钟档做判读,频率本身有使用逻辑,不是越高越好。曲线怎么先建基线、再用四种形态标记、最后做三维交叉验证,见〖分钟级阅读增量曲线的判读框架与频率档位〗。
历史趋势导出:从“一次性Excel”升级为“持续更新的对照序列”。 趋势的价值在纵向可比,不在单点高低。API回采让“拉多个账号、拉更长时间”从一件需要专门安排人力的事,变成可以定时跑的例程;5路并发下20个公众号的数据采集从10秒压到2秒,维持例程的摩擦力被降到足够低。回采近 5 年历史、按时间序列返回数据的路径,见〖公众号历史阅读量趋势的回采与导出路径〗。
下拉词采集:从“体力复制”升级为“结构化候选池”。 采集是起点,选词在词库之上完成。API、RPA、飞书插件三条路径对应不同的技术条件和采集规模,共同的目标是把候选池从“每天几十个”扩大到“几百上千个”,让选词决策有足够的面包屑可以看。 API、RPA、飞书插件三条路径的适用边界,见〖搜一搜下拉词批量采集的三条落地路径〗。
极致了数据在这条路径上的位置
它不是一个“更好的榜单工具”。榜单解决的是“这个领域有哪些号、大致排什么位置”,极致了数据解决的是榜单和手动操作不够用时的那一层:结构化字段可入库、近5年历史可回采、API或飞书插件可自动化。
两个技术选项的分界线不在“先不先进”,在数据最终去哪里、谁来用、多频繁用。飞书插件承担日常运营层的轻量监测和快速浏览,API承担进入数据仓库和BI分析的那条“重数据”管线。选错这条分界线的代价,比选错工具本身更高。
从哪里开始
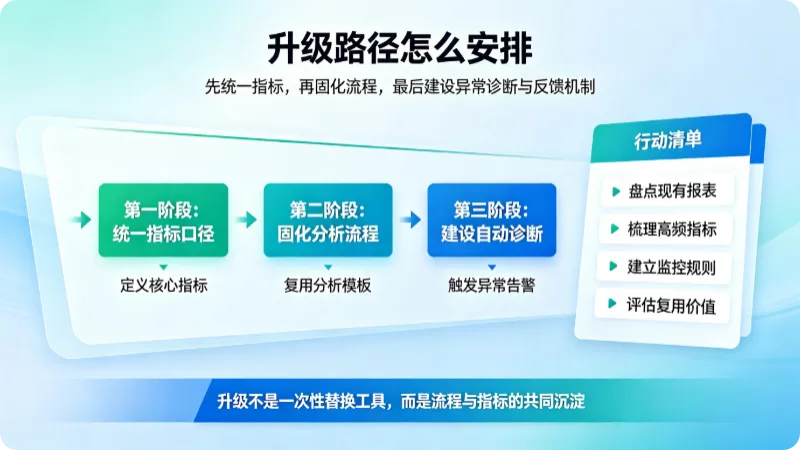
不需要一次到位。新用户有免费试用额度,先跑一个最小验证:把一个竞品公众号的历史文章拉下来,或者跑一组种子词的下拉词采集。验证的不是“工具好不好用”,而是“返回的数据结构能不能支撑你真正想做的那个判读”。
升级的意义不在于用API替代手动,而在于把省下来的翻找时间,重新分配给需要判断力的那部分工作——判断哪个选题值得跟、哪条曲线值得标记、哪个词值得布局。这些判断,手动路径给不了你足够的面包屑,自动化路径给得了。