第三方公众号阅读量准确吗?估算误差、数据边界与刷量识别
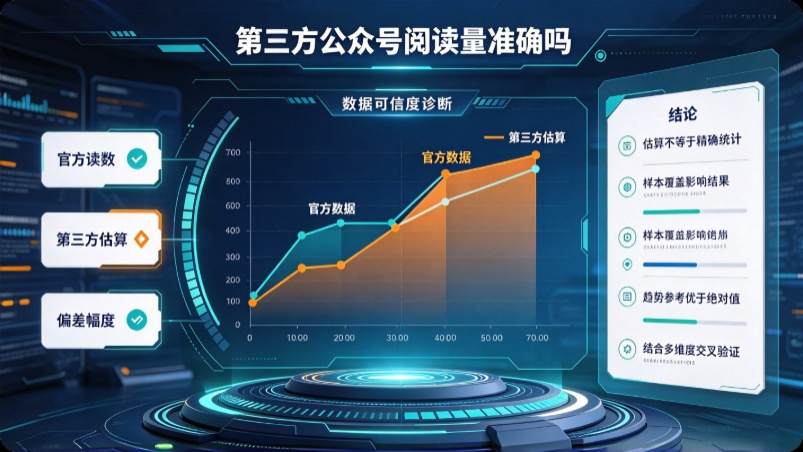
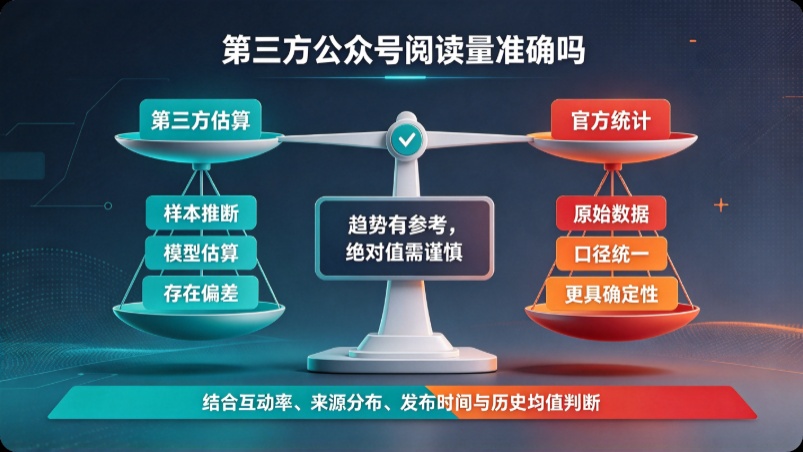
先给结论:第三方平台显示的竞品公众号阅读量,绝大多数是估算值,不是微信官方数据。 误差在部分场景下可达10%—30%。这不是某一家平台的问题,而是结构性限制——微信不向第三方开放任意账号的完整阅读明细和粉丝明细。理解这个前提,才能判断哪些分析可以用估算数据、哪些必须换用高精度数据源。
本文是 [公众号数据分析完全指南] 的数据可信度篇,五种获取方式的完整对比在 [公众号竞品数据怎么查] 中展开。
一、估算误差从哪里来
第三方平台的竞品阅读量通常通过样本监测、算法模型和公开信号推算得出,误差来源主要有四个:样本覆盖不全(平台监测的账号和时段有限)、更新频率差异(T+1和小时级的数据新鲜度不同)、算法模型假设(不同平台对同一账号的推算逻辑不同)、账号活跃度波动(低频账号的估算偏差通常更大)。这意味着,同一个竞品账号在不同平台上的阅读量数字可能不一致,而你不知道哪一个更接近真实值。
二、哪些判断可以用估算数据
行业大盘和账号量级排序:某个领域有哪些头部账号、大致在什么量级,估算数据足够用。选题方向判断:竞品最近在写什么、哪类内容互动偏高,估算数据的趋势信号有参考价值。初步筛选:从一批账号中圈出值得进一步关注的候选,估算数据可以作为第一层过滤。这些场景的共同点是方向判断——错了可以修正,成本可控。
三、哪些判断必须用高精度数据
投放前验真:你要为一个账号的阅读量付费,10%—30%的误差直接对应预算损失。竞品单篇增速对比:两篇阅读量接近的文章,增速曲线可能完全不同,估算数据看不出增量形态。异常流量识别:刷量往往体现在增量曲线的突兀变化和互动数据的脱节上,估算数据无法支撑这种粒度的判断。长期趋势回归:年度或季度趋势分析需要稳定的历史数据序列,估算值的口径变化会污染趋势结论。这些场景的共同点是决策依据——依据错了,后续动作全部偏离。
四、刷量识别的五个信号
刷量不是“阅读量高”本身,而是数据之间的关系不符合自然传播规律。以下是五个可观察的信号:
阅读增量呈直线拉升而非自然爬坡。 正常传播有爬坡、峰值、衰减的曲线形态;刷量往往在短时间内出现近乎直线的增量。
点赞/在看与阅读严重脱节。 阅读量很高但在看率远低于同类内容,或互动数据在某个时点突然集中出现。
转发曲线无同步增长。 阅读在涨,但转发数据没有对应的增长节奏——真实传播中阅读和转发通常有相关性。
凌晨时段的异常增量。 目标读者活跃度最低的时段出现明显阅读增长,需要警惕。
多篇数据形态高度雷同。 不同文章、不同选题的增量曲线如果呈现几乎相同的形状,不符合自然传播的随机性。
五、分钟级监测如何辅助判断
分钟级监测以60秒级的粒度追踪阅读、点赞、转发的增量,核心用途不是“看得更细”,而是让曲线形态可见。正常传播的曲线有自然的爬坡和衰减,刷量的曲线往往突兀、缺乏互动配合、且在多个账号或多篇文章间呈现雷同形态。对于高价值竞品或待投放账号,跑72小时增量曲线再结合互动比做交叉验证,比看一个静态的阅读总数可靠得多。
数据可信度的使用原则可以浓缩为一句话:估算数据做方向,高精度数据做决策。 方向判断错了可以修正,决策依据错了直接造成损失。两者不是替代关系,而是分层关系。
延伸阅读:数据来源的精度层次与选型框架,见 [公众号数据分析完全指南] 。如果你需要对比不同获取方式的成本,见 [公众号竞品数据怎么查] 。