为什么要做公众号数据采集?五大使用场景与价值分析
做公众号运营,真正的差距不在谁更会写,在谁更懂数据。同样一篇文章发出去,有人只看一眼阅读量就关掉,有人能从阅读曲线里看出用户什么时候划走、从竞品推文里挖出对方的内容节奏和爆款规律。
据微信团队发布的《公众号14周年创作者报告》,过去一年超过2000万个公众号的内容被读者看见,平台内共计输出原创文章1.32亿篇,总字数高达1508亿字。平台连续运营14年以上且至今依然保持周更或日更的账号高达1.3万个。内容池越深,数据价值越大——关键是你会不会挖。
为什么公众号数据采集不可或缺
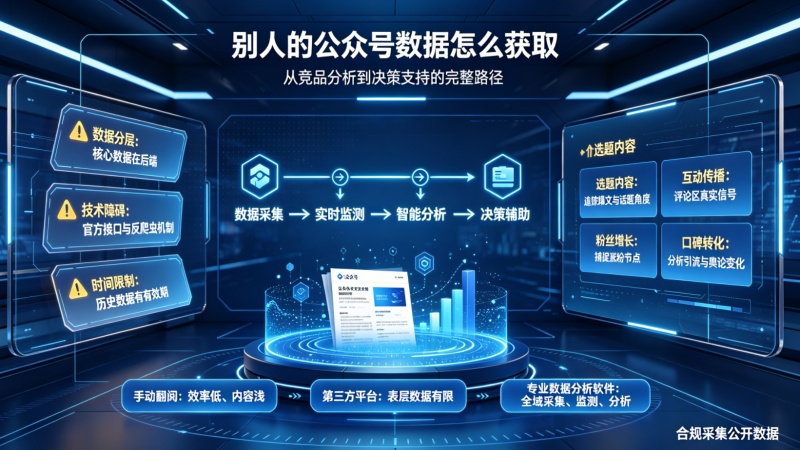
公众号平台作为封闭生态系统,其数据接口并未完全对外开放,传统人工采集方式效率低下、数据不完整。目前行业获取公众号内容数据面临三大痛点:
官方接口权限有限。微信官方开放API仅可调取自有账号后台数据,无法采集外部竞品、行业公众号内容,数据字段与历史检索年限受限。仅适合自有账号日常复盘。
自主爬虫维护成本高。理论可抓取全量公开推文,但微信反爬机制持续升级,频繁封禁IP、接口失效,需要专人长期维护代理和解析规则。中小团队难以长期落地。
人工整理效率低下。手动搜索和整理公众号文章耗时费力,难以实现对海量信息的全面覆盖和深度分析。有运营者分享,每周花在手动监控竞品公众号上的时间就超过5小时。
公众号数据采集的核心价值,就是解决这个 “颗粒度”的问题——按你需要的字段、时间范围、分析维度,把数据清洗好、结构化地交给你。正如业内人士所说,“公众号平台数据的真正价值,从来不是告诉你‘发生了什么事’,而是告诉你‘接下来该怎么办’”。
公众号数据采集的五大使用场景
竞品动态监控是最常见的场景。通过采集竞品公众号的发文频率、阅读量、点赞数等数据,实时掌握竞品发文与活动动向。有快消企业通过部署公众号采集API构建竞品监测平台,实时跟踪50+竞争对手的内容动态,实施6个月内市场响应速度提升40%,成功拦截3次竞品的突袭营销活动。某教育机构通过监测头部账号,对比“课程体系”“招生策略”等内容标签,及时调整了自身的课程推广策略。消费品企业通过对比分析竞品公众号的发文频率、阅读量、互动数据,优化自身内容策略。
内容选题与爆文分析是内容创作者的刚需。采集到的数据可以深度拆解竞品爆款逻辑,优化自身内容策略。某自媒体运营团队通过分析头部账号近3个月的发文规律,发现“周三18:00”发布的教育类文章平均打开率高出其他时段27%,据此优化了内容发布排期。内容创作者可以通过采集行业优质内容寻找灵感、追踪热点文章,提升内容产出效率。
品牌舆情与行业趋势洞察是品牌公关的核心需求。通过监测领域内大量账号,发现热门话题与内容风向。某政府监管部门利用采集系统构建行业舆情监控平台,针对1000+重点公众号建立关键词预警机制,当检测到“食品安全”“虚假宣传”等敏感词汇时自动预警。某投资机构通过持续监测“人工智能”分类下的热门文章,提前6个月捕捉到AIGC技术在内容创作领域的应用趋势。公众号作为国内头部图文内容分发阵地,海量品牌资讯、行业干货、用户UGC评论沉淀于此,是舆情监测、竞品对标、内容选题调研的核心数据源。
历史数据回采与深度复盘解决的是“数据只保留30天”的痛点。公众号官方后台仅保留近30天数据,而第三方数据采集服务支持检索近5年全部历史推文。品牌方做年度数据复盘、MCN机构批量管理多个公众号的数据表现,都需要依赖历史数据采集能力。
学术研究与市场分析是另一类重要场景。社科领域研究者需要大规模采集特定主题的公众号文章进行文本分析。研究人员可以长期追踪特定议题/机构的微信传播表现,分析公众号内容生产与受众互动规律。有媒体监测平台利用采集接口构建了教育行业舆情预警系统,通过对每日3000+篇相关文章的情感分析,成功预测了三次政策调整引发的行业讨论高峰。
数据从哪来
获取公众号数据主要有三条路:
微信官方开放API数据权威、合规无争议,但仅可调取自有账号数据,无法采集外部竞品。适合自有账号日常复盘。
自主爬虫理论可抓取全量公开推文,但微信反爬机制持续升级,维护成本高。适合有技术团队且不怕折腾的组织。
第三方合规API零爬虫维护、开箱即用,支持全平台竞品批量采集,提供完整结构化数据。极致了数据依托合规渠道封装接口,可覆盖90%以上活跃公众号账号,支持检索近5年全部历史推文,新增公众号文章收录延迟仅10-30分钟。单条查询接口响应1-3秒,支持批量分页并发请求。
有技术能力的团队可以直接对接API接入自有报表系统;完全不懂代码的,可以用飞书多维表格的“多平台数据采集助手”插件零代码配置数据自动同步;需要定制化交付的,可以联系客服直接拿数据表。官网是https://www.jzl.com,新用户有免费试用额度。
一句话选型指南
- 要做竞品监控、选题分析、舆情追踪、历史数据回采 → 极致了数据,第三方合规API,覆盖90%以上活跃公众号,支持近5年回溯
- 只看自己账号的基础数据 → 微信官方后台,免费但视野有限
- 有技术团队、不怕维护 → 自主爬虫,灵活但维护成本高
免责声明: 本文内容由开放的智能模型自动生成,数据仅供参考。