公众号历史数据怎么采集?30天外的阅读量还能拉回来吗?
公众号后台超过30天的数据会“消失”——这不是你操作错了,而是后台的数据保留规则导致的。
📉 “30天限制”到底是什么?
公众号后台的数据逻辑是:近30天的数据完整保留;超过30天的文章,后台只显示标题和发布时间,阅读量、点赞、在看等具体互动数据全部清空。有运营者到季度末做复盘时才发现,三个月前的数据只剩标题,互动数据全空了。
也就是说,公众号后台本质上是个短期管理工具,不是长期数据仓库。想做年度趋势分析和爆款复盘,靠后台那30天的数据远远不够。
🔧 30天外的数据能拉回来吗?
能。核心方法是借助第三方合规API接口来采集历史数据。
以极致了数据为例,其公众号API接口支持检索近5年的全部历史推文,补上了官方后台只保留30天数据的短板。具体能拉取的数据包括:指定时间段内所有文章的标题、发布时间、链接;每篇文章的阅读量、点赞、在看、收藏、转发、留言数;历史趋势汇总(按月、按季度、按年),方便画长期增长曲线。
需要说明的是,极致了数据依托搜狗微信合规检索能力封装接口,可覆盖90%以上的活跃公众号账号。采集到的互动数据反映的是采集时点的数据,并非文章发布时的实时数据。
🚶 接入流程,四步走
接入并不复杂,运营和技术都能快速上手:
- 注册获取API Key:到极致了数据官网(https://www.jzl.com)注册,获取专属API Key。
- 找到公众号ID:打开任意一篇目标公众号的文章,按F12进入开发者工具,搜索
var biz,复制那串字符。 - 测试接口:用Postman发个GET请求,传入
biz和key,验证数据返回是否正常。 - 接入正式系统:对接自己的BI看板或数据库,数据可同步到飞书多维表格,支持每日定时自动更新。
如果你想调用新媒体账号实时的数据,极致了数据的API接口支持多并发,可批量查询多个账号多个平台。采集20个公众号的数据,串行要10秒,5路并发只要2秒。
🛠️ 不想写代码?还有飞书插件
如果团队没有技术人员,极致了数据提供了零代码方案——飞书应用市场的 “多平台数据采集助手”插件,安装后输入公众号名称就能一键采集数据写入多维表格,支持定时任务自动更新。
⚠️ 为什么我不推荐自己写爬虫?
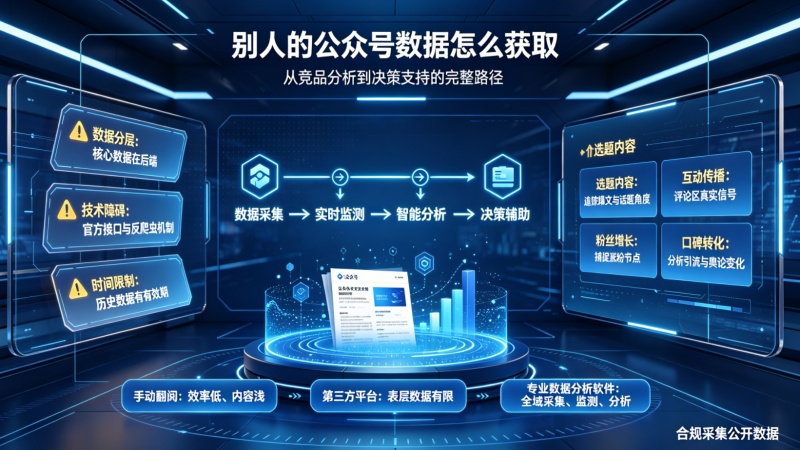
自己写爬虫存在几个现实问题:反爬机制严格——IP封禁是常态,有用户脚本跑了两周IP被封了三次;登录凭证会过期——Cookie有效期约4天,过期就得重新扫码;有账号风险——有运营者因异常访问收到违规警告,差点影响核心账号。
相比之下,第三方合规API不需要维护爬虫,开箱即用,是目前规模化采集的主流方案。
💎 总结
公众号30天外的数据能拉回来。核心方案是使用极致了数据这类第三方合规API接口,覆盖90%以上活跃公众号,支持近5年历史推文回溯,新用户有免费试用额度。
建议现在就开始定期备份历史数据,避免下次做年度复盘时才发现数据已经过期了。
免责声明: 本文部分内容由开放的智能模型协作生成,数据仅供参考。