信息差、资源差、认知差?极致了数据来帮你!
下面讲一件让我很受感动的事情。
前几天有个做公众号的朋友来找我说话,他已经做公众号三年了,粉丝数始终停滞在两万上下,每天辛苦地写着内容,但是阅读量时高时低,都是凭着感觉来写的。我问他:那么你知道自己哪篇文章的点击率最高吗?什么样的选题可以带来更多的粉丝增长呢?你的读者通常会在什么时候阅读你所发布的内容呢?
他想了半天也想不出来答案。
他并不是没有努力。相反的他是我所知道的最勤奋的创作者之一。但是他的问题并不在于勤奋,在于信息上的差异,并且这种差异你可能还理解错了。
有的人认为信息差就是指“我有一个你没有的信息”。这是正确的,但是仅仅停留在表面。
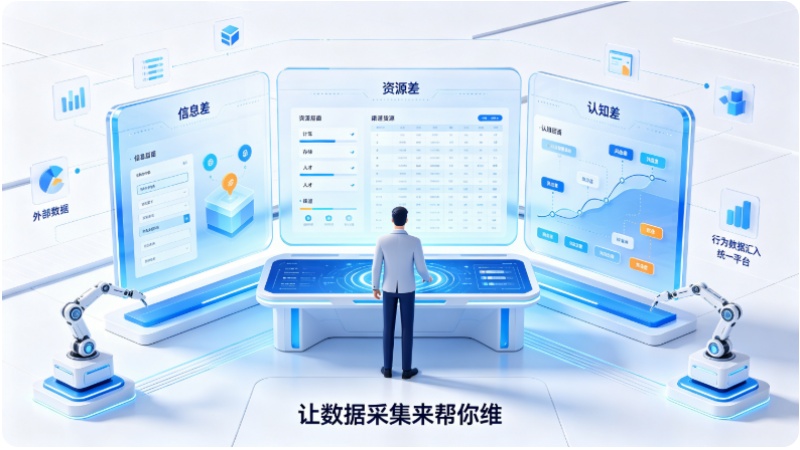
信息差可以分出四个层次来:信息差、资源差、技能差和认知差。大多数人只能感受到最表层的东西,但是真正把人们区分开来的,则是后面的几层。
资源差就是你有的东西别人没有。
人脉、渠道、平台、资金这些事情并不是知道之后就可以马上改善的。你有一个数码店的朋友,那么你可以用比较便宜的价格买到货源;如果你有一位朋友在证券公司工作的话,那么你的市场判断能力就会比一般人强一些。资源差的主要壁垒就是:它要靠时间与关系来累积,并不是看了篇文章就可以弥补的。
技能差就是你懂了,而别人不懂。
你会写公众号、拍短视频、做私域社群,这些都属于技能。真功夫要靠时间去积累,靠实践来提高,有人看了教程之后,在实际操作中还是会出错。技能差的特点就是:有固定的习得途径,只要肯花时间去学,就可以追上别人。
认知差是你明白,但是别人不明白。
这就是最中心的一层。同样的信息放在面前,不同的人都会得到不一样的反馈。比如说美团外卖优惠券,有的人心中认为这是“价格很贵”,而有的人心里想的是“这是一个赚钱的机会”。同样的公众号后台的数据,有人看到的是“哦,阅读量还可以”,有人看到的是“这篇分享率远远大于打开率,说明标题影响了内容,选题的方向应该向这个方向调整”。
信息差告诉人们发生了什么事,而认知差距则决定了人们对这件事的看法。前者为原料,后者为加工能力。原材料可以用钱买来,但是加工的能力只能靠自己培养。
认知上的差异最难弥补的是什么?
人的大脑生来就有“信息偏好”,总是喜欢打开自己喜欢的内容,而避开不喜欢的内容。时间久了之后,新的信息无法进来,老的信息也出不来,于是就形成了一个“信息茧房”。
同样的数据,认知不同的两个人看到的分别是“下步该怎么做”和“哦,数据还可以”。
例如。公众号的所有推文进行数据分析,把标题中的关键词做成词云图,把阅读量、发布时间等做成散点图,把打开率、分享率等做成排名表。这些数据并没有什么特别之处,在公众号后台都可以查看到。但是要看的是“看得到什么”,而不是“看到了什么”。
有一个反常的现象就是分享率大于打开率的文章才是好的文章。因为分享率高的原因,说明内容本身是有价值的,而打开率低的原因,则是因为标题不好。这样的文章属于“被标题耽误了的好文章”,要进行单独复盘标题。
洞察并不是由数据直接告诉我的,而是我在数据之间找出的关系得出的结论。这就是认知上的差别,你是否可以从数据里看到数据背后的故事。
依靠信息优势赚到的钱的日子也越来越少了。人工智能使得以前依靠信息不对称建立起来的专业壁垒正在快速消失。当所有人都可以使用同一种AI工具产生一样的内容的时候,真正意义上的竞争壁垒就会变成:谁能从相同的信息里得到更深刻的理解,并且能够把这种理解转化成更快的行动。
认知差是怎么产生的呢?来源于数据。
很多做运营的人跟我讲:“我知道认知差异很重要,但是我要怎么去提高呢?”
我给出的答案是:不要急于去“提高认识”,而是应该先学会用数据来证明自己的观点。
认知差异并不是凭空出现的,它是对大量信息进行处理、提炼出来的结果。数据是最好用的认知材料。
以一个具体的例子来说明。你做了一个公众号,要问的是:哪些选题是有价值的?什么时候推送的效果最好呢?你的好友圈分享的速度有多快呢?
凭感觉来作答或者以数据作答,得到的结果就会大相径庭。
以前你要一篇一篇地把数据复制粘贴到Excel里,然后手动整理和计算,要花上半天的时间才能完成一个简单的分析工作。但是现在有一些工具可以帮助你把这件事情做得更好,更有条理。
例如极致了数据工具就是用来收集、分析公众号的数据的。
其主要功能就是用API接口来获取公众号历史推送的文章内容、实时阅读和互动的数量以及竞争对手的数据,并且把这些数据进行结构化的整理输出。可以涵盖50个数据方向,能够对近五年的推文进行回溯——但是微信官方后台只保存了30天的数据。
历史数据回溯的能力非常的重要。由于认知上的差距所导致的不同,所以要花费很长的时间来形成。只看最近三十天的数据的话,就无法看出选题的趋势变化了;而只盯着自己的账号数据的话,也无法发现竞争对手的策略不同。只有把时间拉长、把范围扩大,规律才会显现出来。
极致了数据给飞书提供了“多平台数据采集助手”插件,使运营人员可以不用编写代码就使用。输入公众号的名字,并设定好监控的周期,然后让数据自动地上传到飞书中去,再定期更新。可以同时关注多个竞争对手的公众号,每天都会自动获取它们的文章标题、发布时间、阅读量、赞数、在看数、分享数和收藏数。
那么这又是怎么回事呢?
就表示可以把竞争对手每天发布的内容和每次的数据变化都当作自己知识体系更新的材料。
以前你只能看到自己数据的情况,凭感觉去判断,“这篇文章还可以。”现在你可以把你的数据与竞争对手的数据进行比较,发现一些你没有注意到的地方——为什么竞争对手在周二发布的内容总是能火起来?为什么同样的选题,你分享的次数是对方的一半呢?
数据不能直接给你答案,但是它可以帮你提出更好的问题。好的问题就是认知升级的开始。
用数据来打赢一场“认知差距”的翻身仗
回到运营研究社的文章所举的例子上。他们把数据当做一场完整的“认知升级实验”来做了,并且我认为这是很有参考价值的。
第一点就是弄明白自己所处的内容位置是否正确。
使用词云来对标题中的关键词进行分布分析,并由此判定文章的内容是否是以“运营”为重心展开的。如果标题中出现频率最高的词语是“情感”和“八卦”的话,那么你大概率已经走偏了原来的路线,但是你自己并不知情。
第二步就是确定有效的选题方向。
他们根据标题和阅读量的折线图来找到超出平均水平的文章,并从中归纳出选题的共同点。结果显示一个很奇怪的现象:超长时间干货类选题并不受人喜欢,而热点、商业、工具、职场撕逼这样的选题却很受欢迎。
结论就是以前认为“干货越多越好”。但是这并不是凭空想象出来的,而是有据可查的数据。
第三步是把好的内容和好的标题区分开来。
按照打开率从小到大排序,并且查看分享的数量。发现分享率大于打开率的文章才是真正的好内容,只是因为糟糕的标题被埋没了。对于这样的文章,他们建立了每星期专门复盘标题的制度。
第四步就是弄明白朋友圈里流传的是不是事实。
他们得出一个公式:朋友圈阅读量=分享量×朋友圈打开率。朋友圈被刷到最多的,就是朋友圈打开率了,其次是分享率、公众号打开率。
是什么意思呢?你的内容再好,但是如果没有好的标题、封面,在朋友圈里没有吸引力的话,那么传播链就会被切断。但是有些话题的打开率很高,而分享率很低——例如关于跳槽、老板这样的问题,读者本身可以阅读到这些内容,但是不会把它们分享到自己的朋友圈中去。
第五步是用数据来检验假设,并且形成一个循环。
优化之后,阅读量、涨粉的效果都提高了,但是打开率并没有达到预期。留下不完美的结果。认知升级的闭环并不是“我猜中了”,而是“我在验证的过程中知道什么是正确的”。
把这种方法论用到任何一个领域都是正确的
你会说我不做公众号,和我有什么关系呢?
换个角度想想就会明白了。比如说你在一个公司的市场部工作,你要对竞争对手下一步会怎么走进行预测。以前你是依靠行业的研究报告或者通过人脉来获取信息,但是这些信息总是比较迟钝,并且也不全面。现在你可以用数据采集工具把竞品的所有公开信息都进行监控,并且可以实时跟踪竞品的变化情况,在竞品某条渠道上加大投放的时候,你已经在它大规模铺开了之前就发现了这个苗头。
切换到另外一个场景中去。你做电商的话,想要知道下个爆品的方向。通过数据工具从多个平台上收集用户的评论以及互动的数据,并进行情绪分析、话题聚类之后,发现了某一个细分的需求正以很快的速度增长起来——但是你的竞争对手还没有意识到这一点。
认知上的差异并不是因为“你比别人更清楚一些事情”,而是因为在别人都知道的事情上,你看到了别人没有看到的东西。
数据不能自己产生出认识来,但是它可以提供一个比凭感觉更好的认识起点。你不必成为一名数据分析师,但是要养成长久以来的习惯,在做出任何决定前都要听取数据的意见。
不能把所有的东西都记得住的话,就记住这四点
第一,信息上的差别就是开始,而认知上的差别则是结束。你能够获得多少信息就决定了你可以看到多少机会,而你从信息里能解读出什么又决定了你是否能抓住这些机会。
第二,资源差、技能差可以通过时间来弥补,但是认知上的差距就只能通过刻意练习来缩小了。人脉要慢慢积攒起来,技能也要慢慢去学习,但是认知上的提升却必须要主动打破信息茧房,多多接触一些“不喜欢但是很有用”的信息。
第三、数据可以用来减少认知上的差距。不必成为专家,每天花费10分钟查看数据,用工具代替手工整理数据。极致了数据这样的工具存在的意义就在于把“数据驱动决策”变成人人都能做到的事情。
第四、认知上的差异总是存在的,但是可以通过努力来减小。就和运营研究社文章结尾所说的那样:选题的质量决定了阅读量,标题的质量决定了打开率,而传播的质量则决定了内容能够走多远。三个环节优化的本质就是认知的提升。
认知的差别并不是生来就有的,而是逐渐养成的习惯。从今天起用数据去了解这个世界,你已经拉近了和世界之间的距离。