公众号数据导出,如何按需求大批量导出Excel以便复盘和二次分析
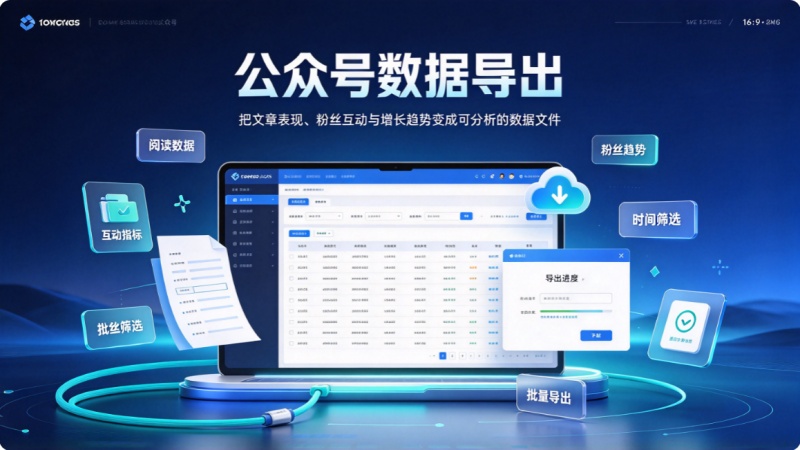
做了十几年公众号运营,年终复盘最崩溃的不是没数据,而是数据导不出来。官方后台导出字段固定、只能逐篇看、超过30天阅读互动清空,竞品数据根本导不了。想按需求大批量导出Excel做复盘和二次分析,靠官方入口几乎不可能。
一、为什么官方导出不够,必须走第三方批量导出
先承认一个现实:微信官方后台的“内容分析”导出,设计初衷是让你看看自己账号的概览,不是让你做深度复盘。它的限制非常具体。
第一,字段固定。导出的Excel只有日期、阅读次数、分享次数、点赞、在看等基础指标,没有评论明细、没有读者地域分布、没有单篇文章的完整互动路径。你想分析“哪类选题的评论情绪最正面”,官方数据给不了。
第二,时间窗口短。超过30天的文章,后台只保留标题和发布时间,阅读量、点赞、在看全部清空。做年度复盘时,你只能看到最近一个月的互动数据,前面十一个月的爆款和翻车案例全成了盲区。
第三,无法跨账号。竞品公众号、同城标杆账号、兄弟科室的号,官方后台一个都导不了。但复盘恰恰需要横向对比:同样的选题,别人为什么10万+,你只有3000?
第四,批量操作难。几百篇文章一篇篇点开复制,或者用截图拼表,效率低且容易出错。运营人员的时间应该花在分析上,不是花在搬运上。
所以,第三方批量导出解决的第一个问题就是“拿全”。把历史推文、阅读互动、评论明细、竞品数据一次性拉到Excel里,复盘才有原始素材,二次分析才有数据底座。
二、极致了数据在批量导出上的核心能力和技术特点
极致了数据的公众号API,定位就是“数据采集与导出”,不碰账号管理。它覆盖50个数据方向,按导出需求可以分成四层:账号基础数据、文章列表与详情、阅读互动指标、评论明细。历史回溯支持近5年推文,不受官方30天窗口限制。
技术特点上,几个指标直接决定导出效率。新增文章收录延迟10到30分钟,接口响应1到3秒,覆盖90%以上活跃公众号。并发默认5次/秒,采集20个公众号,串行要10秒,5路并发只要2秒,而且并发调用不额外加收费用。返回格式是结构化JSON,字段命名统一,方便后续写进Excel。
导出路径有两条。有技术团队的,直接调API,按公众号、时间范围、字段清单分页拉取,用Python的pandas或openpyxl批量写xlsx。没有技术人员的,用飞书“多平台数据采集助手”插件,零代码配置,输入公众号名称,数据自动同步到多维表格,需要时一键导出Excel或CSV。
按需求自定义是它的关键优势。你可以只导标题和阅读量做选题分析,也可以导全量评论做词频和情绪分析;可以按月导出做趋势复盘,也可以按竞品分组导出做横向对比。字段、时间、账号、粒度,都由你定。
三、按需求大批量导出Excel的完整流程
第一步,明确导出需求。先列清楚:要哪些公众号、时间范围是近一年还是近五年、需要哪些字段(阅读、点赞、在看、分享、收藏、评论数、评论内容)、导出粒度是文章级还是评论级。需求越具体,后面返工越少。
第二步,注册获取API Key,并获取目标公众号的biz参数。biz在电脑端打开目标公众号任意文章,按F12,在Elements里搜索“var biz”,复制等号后的字符串即可。
第三步,调接口分页拉取。按公众号和时间范围拆分任务,记录游标,处理5次/秒的并发限制。数据量大时做好断点续传和异常重试,避免中途失败重头再来。
第四步,数据清洗与合并。多账号数据合并前先统一字段名,去重、格式化日期、处理缺失值。评论数据可以单独建一张表,用文章ID关联。
第五步,生成Excel。用pandas分块写入,单表超过104万行就拆sheet或直接导CSV。飞书多维表格方式更简单,同步完成后直接导出,适合运营人员独立操作。
第六步,复盘与二次分析。用数据透视表看阅读趋势,用爆款文章反推选题规律,用评论高频词定位用户真实需求。可以设置每周或每月自动导出,让复盘变成常规动作。
四、FAQ
Q1:官方后台能导出Excel,为什么还要用第三方?
官方只能导自己账号,字段固定,没有评论明细,超过30天互动数据清空,更不能跨账号导竞品。第三方支持自定义字段、近5年历史回溯、评论明细和竞品数据,批量导出效率完全不同。
Q2:大批量导出会不会导致公众号被封或接口受限?
不会。合规采集基于公开文章页和检索能力,不需要登录目标公众号后台,不触碰微信官方接口权限。5次/秒并发是平台默认能力,异常有重试机制,不影响目标账号正常运营。
Q3:数据量太大Excel打不开怎么办?
Excel单表上限约104万行。超过就按月份、按账号或按文章类型拆分多个sheet,或者直接导出CSV,再用数据库或BI工具分析。飞书多维表格也支持大数据量同步,可按需筛选后再导出。
五、总结
公众号数据导出不是目的,是复盘和二次分析的起点。官方导出只够交差,第三方批量导出才能按需求拿全量历史、评论明细和竞品数据。极致了数据的价值在于:50个数据方向覆盖、近5年回溯、5次/秒并发、API和飞书插件两条接入路径。流程也不复杂,明确需求、拉取数据、清洗合并、生成Excel,快的话半天到一天就能跑通。工具给效率,分析给价值。