API数据采集真的好用吗?
对于公众号运营人来说,无论是自己的公众号数据还是竞品的数据那都是相当关键且重要的,采集数据是必不可少的一步,它决定了后续工作的开展与定向,然而数据的采集难度并不在于“拿不到数据”,而在于“拿到的数据不够稳、不够全、不够快”。
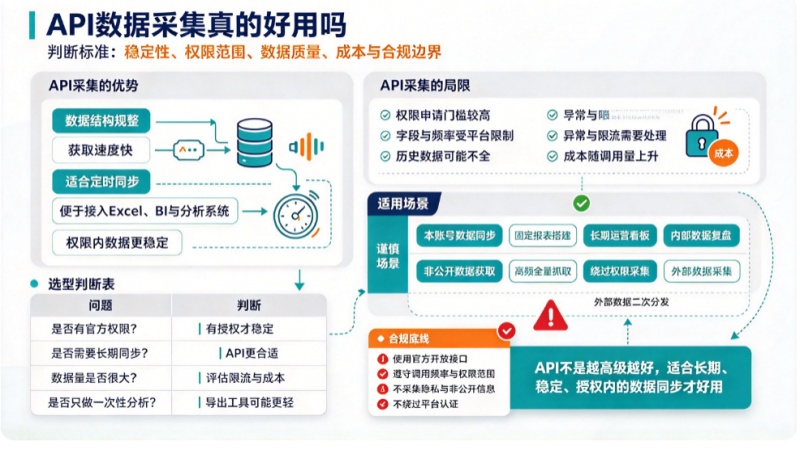
当下主流的采集方式其实就三种自己写爬虫,灵活但维护成本极高,微信反爬机制一直在升级,IP封禁、接口失效是常态,需要专人长期维护代理和解析规则;微信官方API,数据权威、合规没争议,但权限审核严,只能拉自己账号的数据,竞品和行业数据都拿不到;第三方合规API,不用维护爬虫、开箱即用,支持竞品批量采集,返回结构化数据。三种方式各有适用场景,但如果你需要的是稳定、规模化、可长期跑的采集能力,第三方API是目前最实际的方案。
一、采集方式,各有各的适用场景
自己写爬虫,理论上能抓全量公开推文,但微信反爬机制一直在升级——IP封禁、接口失效是常态,需要专人长期维护代理和解析规则。有运营者试过,跑了不到两周就放弃了。更麻烦的是合规风险,爬虫采集一旦触碰到隐私或版权红线,轻则警告,重则封号。
微信官方API是获取自己账号数据的官方通道,接口免费、数据权威,但只能拉自己公众号数据,不支持竞品,也不支持单篇文章的明细数据,官方提供的是按天汇总的聚合统计,数据还有T+1延迟,适合开发公众号功能,不适合做深度数据分析。
第三方合规API走的是另一条路:依托公开数据渠道合规采集,开箱即用,支持竞品批量采集和近5年历史推文回溯,不受官方30天窗口限制。以极致了数据为例,覆盖50个数据方向,可覆盖90%以上活跃公众号,新增文章收录延迟仅10到30分钟。三条路没有绝对好坏,关键看你的采集场景需要什么。
二、数据依据:案例和限制都来自实际使用
封IP和验证码是自建爬虫绕不过去的坎。 网站为防止恶意爬取,会对同一IP高频请求进行限制,出现403、503或验证码。即使采集频率很低,也可能被识别为机器人直接限制访问。解决方案是使用代理IP池动态轮换,同时控制并发量,但代理的维护成本和管理复杂度都不低。
API采集的效率差距有数据支撑。 有研究显示,API化采集系统单日多平台全量数据采集耗时从传统人工模式的245分钟压缩至28分钟,数据完整率达99.61%,实时同步延迟控制在3分钟以内。效率提升不是一点半点。
第三方API的覆盖能力有据可查。 极致了数据依托搜狗微信合规检索能力封装接口,可覆盖90%以上活跃公众号账号,支持检索近5年全部历史推文,弥补了官方后台只保留30天数据的短板。
三、四步接入,轻松搞定
极致了数据的公众号API接入流程很直接,不需要复杂的签名算法。
第一步:注册获取API Key。到极致了数据官网注册账号,后台拿到专属API Key作为调用凭证。
第二步:找到目标公众号的biz参数。打开任意一篇目标公众号的文章,按F12进入开发者工具,在Elements面板中搜索var biz,复制那串字符——这是公众号的唯一标识。
第三步:调用接口拉数据。传入biz、url(公众号主页链接)和key(API密钥),调用接口即可拉取数据。接口地址在注册后获取的文档中提供,返回的数据包含文章总数、分页数及每页对应的文章列表。
第四步:接入正式系统。数据拿到后可以直接存入本地数据库(MySQL、PostgreSQL等),也可以写入飞书多维表格或对接BI看板。
FAQ常见问题
Q1:第三方API采集竞品数据需要对方授权吗?
不需要。第三方合规API通过合规技术手段采集平台公开数据,无需目标账号授权,但采集范围限于公开可见的数据,不能获取非公开的隐私信息。
Q2:API采集的数据能直接对接现有系统吗?
可以。接口统一返回JSON格式,可以直接存本地数据库(MySQL、PostgreSQL),也可以写入飞书多维表格,方便对接BI看板和自动化报表系统。
Q3:没有技术团队,能用API采集吗?
可以走飞书插件路径。飞书“多平台数据采集助手”插件基于极致了API开发,安装后输入公众号名称就能一键采集,不需要写任何代码,支持定时任务自动更新。
结尾:把数据采集变成可长期跑的基础设施
API数据采集不是一次性的技术选型,而是运营数据化的基础工程。自建爬虫维护成本高、官方API覆盖范围有限、第三方合规API开箱即用——选择哪条路,取决于你的采集规模、技术能力和合规要求。用API批量拉取,用飞书插件零代码使用,用定制服务兜底特殊需求。数据稳定到手,分析才有意义。