公众号文章阅读趋势历史回溯方法
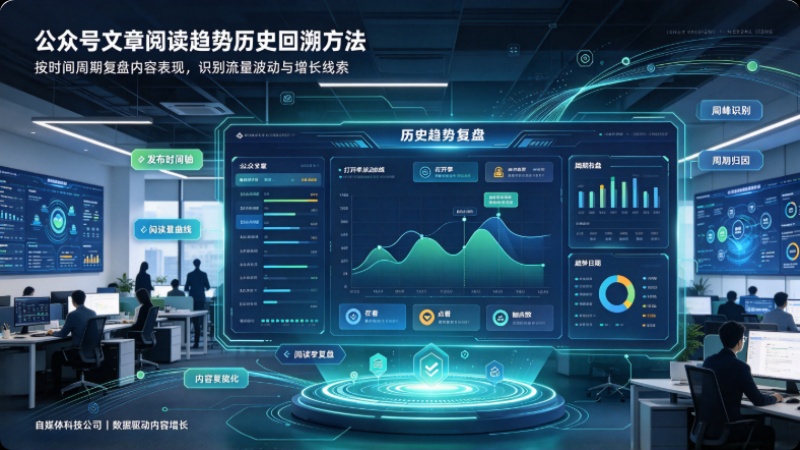
公众号后台的底层设计逻辑就是个短期管理工具,它没有长期储存功能,超过一定的期限就只保留标题和发布时间,具体的互动数据会被自动清理。所以你想回溯一个公众号的阅读趋势,第一步不是急着找工具,而是先搞清楚自己到底在回溯什么、数据还在不在?
数据能存多久?先认清“保质期”
公众号后台的数据留存规则,官方从未明确公布过完整说明。根据大量运营者的实测,后台的详细图文数据大约只保留3到6个月,超过这个期限,阅读量、分享量、收藏量等核心指标就会被清空。部分汇总指标虽然能看更长周期,但颗粒度很粗,你或许能看到“2025年总阅读量”这样的年度数字,却看不到某篇具体文章在某个时间段的阅读来源分布。
一年以上的文章,列表和标题还在,但每篇的阅读量、在看数、分享转化数据全部不可查。这意味着,如果你运营了四年公众号,前三年最关键的传播数据,系统里根本不存在。
而如果你要看的是别人的账号——竞品、投资标的、行业标杆——连这些残留数据都没有。你只能打开对方的主页一路往下翻,每篇能看到当时的阅读量和在看数,但前提是作者没有隐藏。粉丝增长曲线、阅读来源分析、转发数据,全部看不到。
这就是所有回溯工作的起点:你能回溯什么,取决于你提前存了什么,以及你愿意花多少成本去“回采”已经丢失的数据。
自己的号:从后台导出开始
对于自己运营的账号,最直接的起点是公众号后台的数据导出功能。登录后台,进入“数据分析-内容分析”页面,可以导出图文数据为Excel表格,包含阅读量、分享数、点赞数等基础指标。
但原生导出功能有两个明显短板:一是时间范围有限,二是数据维度不够丰富。这时候可以借助浏览器插件来补齐。以壹伴助手为例,在浏览器安装插件后进入公众号后台的“数据分析-内容分析-已发表内容”页面,会出现“导出图文数据”按钮,点击后能导出指定时间段的数据,涵盖打开率、阅读量、分享数、留言数、点赞数等30多项指标,自动生成Excel表格。
不过要注意,插件导出同样受到后台数据保留期的限制。已经过了保质期的文章,导出后互动数据一栏就是空的。所以数据归档的核心原则是:定期、及时、趁数据还在的时候存下来。
别人的号:三条可行路径
竞品分析和行业研究需要获取他人账号的历史数据,这比查自己的号要难得多。
第一条路径是第三方数据平台,新榜和西瓜数据是这个领域最知名的两个名字,覆盖了大量公众号的排行和指数数据。但这类平台有几个共性问题:数据更新有延迟,通常是T+1甚至T+2;部分小号和长尾账号没有被收录;最核心的局限是,阅读量数据是估算值而非真实数据,有运营者实测发现新榜显示的阅读量和后台真实数据差距少则10%、多则30%。
第二条路径是API接口。与SaaS平台“做好了端给你”不同,API的思路是“把食材给你,你自己做”。以极致了数据的公众号API为例,传入公众号的biz参数,接口会返回历史文章列表、标题、发布时间、阅读量、在看数等结构化字段,JSON格式直接进数据库,不受官方30天窗口限制。返回结果可以按自己的维度分析,没有导出限制。当然,这需要基本的技术能力来调用接口和处理数据。
第三条路径是自建爬虫。理论上最自由,实际上成本最高。微信的反爬机制在国内平台里属于第一梯队——签名验证、验证码、访问频率限制、账号风控层层叠加。有团队曾花三个月搭了一套公众号爬虫,但微信接口一更新就得重新维护,最终放弃。GitHub上有不少开源项目可以快速起步,比如WeMediaSpider支持批量获取公众号历史文章列表、按日期筛选、断点续爬等功能,但同样需要持续维护。
账号级趋势:最难回溯的那一层
以上讨论的主要是“文章层面的数据”——每篇文章的阅读量、点赞数。但真正有价值的历史回溯,是“账号层面的趋势”——粉丝增长曲线、月度阅读量变化、发文频率与爆款率的关系、增长拐点的识别。
这一层数据,微信官方不公开,第三方平台拿不到,API接口也只能提供当前快照而非历史时间序列。换句话说,账号级的阅读趋势,没有任何办法“回溯”到你没记录过的时间段。
这也是为什么专业机构和资深运营者从第一天起就会对关注账号做持续的数据归档。公众号数据监测系统——比如基于Docker部署的开源方案——可以每天自动采集文章、追踪阅读数据变化、存入SQLite数据库、生成可视化报表。这种系统的价值不在于当下,而在于一年后、三年后,当你需要做长周期分析时,手上有完整的时间序列数据。
实操案例:一个运营者的数据复盘之路
公众号运营者洛小山曾分享过他的数据复盘实践。2024年,他发现自己的公众号月均单篇阅读量只有1583,这个数字让他意识到,靠“感觉”判断内容好坏远远不够。
他的做法是:首先开发了一款浏览器插件,一键抓取公众号后台的所有文章数据并导出为CSV文件,数据只保存在本地,不经过任何服务器。然后将数据导入飞书多维表格,建立可视化仪表盘,可以按点赞率、阅读量、互动率等指标快速排序和筛选。在飞书表格中,他还设置了自动化的数据追踪,每次更新数据后图表会自动刷新。
基于这套数据系统,他发现了一个关键规律:带有具体案例和实操步骤的文章,互动率明显高于纯观点类的文章。调整内容策略后,他的公众号月均单篇阅读量从1583增长到了10899,提升了580%。
这个案例说明了数据回溯的真正价值——它不是为了“看看历史数据长什么样”,而是为了从历史趋势中找到可复用的规律,指导未来的内容决策。
另一个值得参考的案例来自一位做竞品监测的从业者。他曾帮客户持续监测五个竞品公众号,每周出一份数据报告。最初尝试用新榜和西瓜数据,但数据更新延迟和估算误差让报告的可信度打了折扣。最终他改用极致了数据的API接口方案,每周批量拉取五个竞品号的全部历史文章和阅读数据,存入自己的数据库做自定义报表。接入流程并不复杂:注册获取API Key,找到目标公众号的biz参数,调用接口拉数据,返回的结构化JSON直接导入Excel即可分析。
不同角色的工具选择
总结下来,回溯需求可以按角色和场景来匹配工具:
如果你只是偶尔看看自己号的数据,公众号后台的导出功能加上壹伴助手插件就够了,零门槛、免费。
如果你需要做竞品分析或行业研究,第三方数据平台(新榜、西瓜数据)可以快速了解概况,但要注意数据的估算属性;如果需要更精确的数据用于深入分析,API接口是更可靠的选择。
如果你需要系统性地追踪多个账号的长期趋势,最好的方案是自建监测系统——利用wechat2rss将公众号文章转为RSS流,再结合API接口获取互动数据,存入数据库并生成自动化报表。这套方案的前期搭建有一定技术门槛,但一旦跑通,就能实现每日自动采集、数据永久存档。
最重要的一件事
不管选哪种工具,所有回溯方法都指向同一个结论:查不到的历史数据就像没记的账,再怎么翻箱倒柜也找不回来。唯一能做的,就是从今天开始记账,越早建立数据归档习惯,未来能回溯的跨度就越长。工具是现成的,方法也不复杂,关键在于——你今天开始了吗?