公众号 API 数据质量怎么验收?一份接入前回测清单加三项月度体检指标
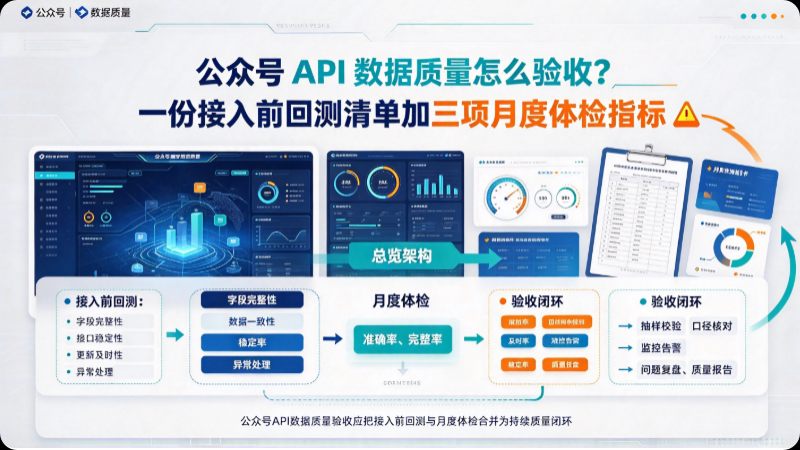
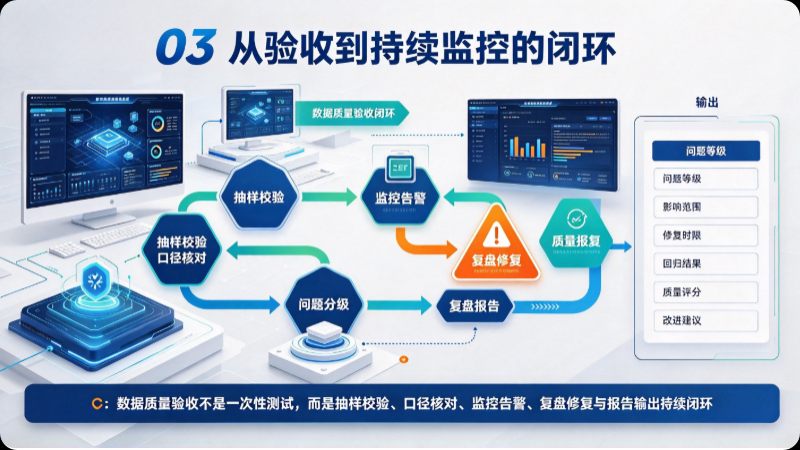
定位:支柱页第四章提出“从能拉到数据到数据可信,中间隔着一层工程验收”,给出了回测和月度体检的方向。这篇集群页把那层验收做成可逐项勾选、有合格阈值、有失败处理动作的操作清单。
站点现有 API 文章覆盖了接入流程、并发调用、飞书集成,但“怎么判断拉回来的数据能不能用”这一点,现有内容停留在概念提示层面。这篇的增量在于把验收拆成接入前的一次性回测和接入后的持续运维两段,每段给出具体的检查项和判断标准。这一层验收在【公众号数据分析的 API 接入与工程验收框架】中的位置,见支柱页第四章。
接入前回测:用 3–5 个你熟悉的账号替代功能清单审查
“覆盖 50 个数据方向”是功能声明,不是质量证据。正式接入前的回测只有一个目的:确认 API 返回值和你在平台页面上看到的值,是不是同一口径。
回测对象选择:3–5 个你熟悉的公众号,其中至少包含你自己的账号(因为你有官方后台可以逐项比对)和 1–2 个数据特征差异较大的竞品(比如一个高频更新、一个低频更新;一个近期活跃、一个历史文章较多)。
拉取范围:每个账号最近 10–20 篇文章。不需要全量,足够暴露口径问题即可。
逐项比对清单:
| 检查项 | 比对方法 | 什么情况下算“通过” | 什么情况下需要追问 |
|---|---|---|---|
| 阅读量 | API 返回值 vs 后台/页面展示值 | 一致,或差异在可解释范围内(如采集时间差导致的增量) | 系统性偏高或偏低,且差异幅度不随文章变化 |
| 发布时间 | 逐篇核对 | 时区和格式正确 | 存在固定偏移(如差 8 小时),或部分文章时间明显错位 |
| 文章 ID/链接 | 去重键是否唯一 | 同一篇文章在不同批次拉取中 ID 一致 | ID 随批次变化,或链接指向与标题不匹配 |
| 历史文章字段完整度 | 对比近期文章与 1 年前文章的字段填充率 | 核心字段(阅读、点赞、在看)在历史文章中的缺失率可接受 | 越早的文章缺失字段越多且无规律,说明历史回溯的字段覆盖有限 |
| 互动数据口径 | 点赞、在看是否与页面一致 | 数值一致或差异可解释 | “在看”和“点赞”字段发生错位或混淆 |
回测中最容易被忽略但最致命的一项,是文章身份的一致性:API 返回的标题、链接和互动数据是否属于同一篇文章。如果采集环节存在窗口错配,可能出现“标题是 A、互动数据是 B”的情况,这类错误在入库后极难排查。
三项月度体检:防止数据在无声中劣化
数据管道最危险的失效不是报错,是“看起来还在跑,但数据已经不对了”。以下三项每月各花几分钟即可完成,关键在于持续做而不是做一次。
体检一:字段缺失率。 统计当月拉取的全部文章中,阅读量、点赞、在看等核心字段为空或为异常值(负数、极大值、与账号量级明显不符)的比例。设定一个阈值(比如核心字段缺失率超过 2% 触发排查),一旦越过就检查是接口字段调整、目标账号变更,还是采集逻辑出了问题。不要把缺失数据直接喂进分析,否则后续的均值、趋势和对比全部被污染。
体检二:重复率与“伪去重”。 用文章 ID 做全量去重后,还要额外检查一类容易被漏掉的重复:同一内容被不同账号转载时,标题和正文可能被微调,文章 ID 不同,但实质是同一篇内容。如果你的分析单位是“独立文章”,按 ID 去重就够了;但如果分析单位是“独立内容”或“选题”,就需要在 ID 去重之外增加标题相似度或正文指纹的二次判断。这项检查不需要每月全量做,但至少每季度做一次,确认去重逻辑是否仍然匹配分析口径。
体检三:增量延迟分布。 对比 API 返回的采集时间与文章实际发布时间之间的间隔,看分布是否稳定。如果延迟的中位数没有明显变化,但尾部(比如 P95)突然拉长,可能意味着数据源侧的收录节奏在特定时段发生了变化。对于依赖“发文后多久能拿到数据”的分析(如首日复盘、分钟级监测),尾部延迟的波动比中位数更能影响结论的时效性。现有产品描述中提到的收录延迟区间,应该作为你监控延迟分布的基准参照,而不是一句读过就放过的产品介绍。延迟数据入库后的历史保留方式见【历史回溯的增量序列保留原则】。
可带走的工具:把回测清单存成一个简单的表格,接入前逐项勾选;把三项月度体检设成日历提醒,每次只填三个数字(缺失率、重复率、延迟中位数/P95)。连续三个月的数据放在一起,就能看出数据质量是在改善、稳定还是缓慢劣化。回测清单和体检指标的使用场景,见【公众号数据分析完全指南中的工程接入章节】。