公众号历史数据回溯该拉多少?按用途分层的采集策略与“增量序列”保留原则
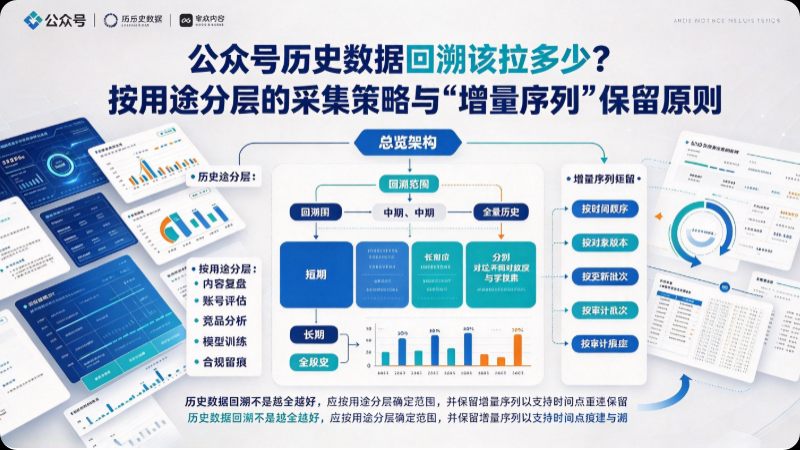
定位:支柱页第四章提出“历史回溯拉多少比能不能拉更重要”,按核心竞品、观察名单、一次性研究做了三层建议。这篇集群页把这个思路展开为一套可以按账号角色分配回溯深度的操作框架,并重点解决一个支柱页点到但未展开的问题:拉回来的历史数据,以什么形态保留才有分析价值。
站点现有文章讨论历史回溯时,重心在“怎么突破官方 30 天限制把数据拿回来”。这篇的增量在于:拿回来之后,保留方式决定了数据能不能支撑推荐时代的分析。 如果只保留每篇文章的一个最终快照,即使拉了 24 个月的历史,长尾信号和推荐放量的时间分布仍然是丢失的。而不是“建立了一套可以反复挖掘的内容基线”。本文对应【公众号数据分析中历史回溯与采集策略的完整框架】的展开操作。
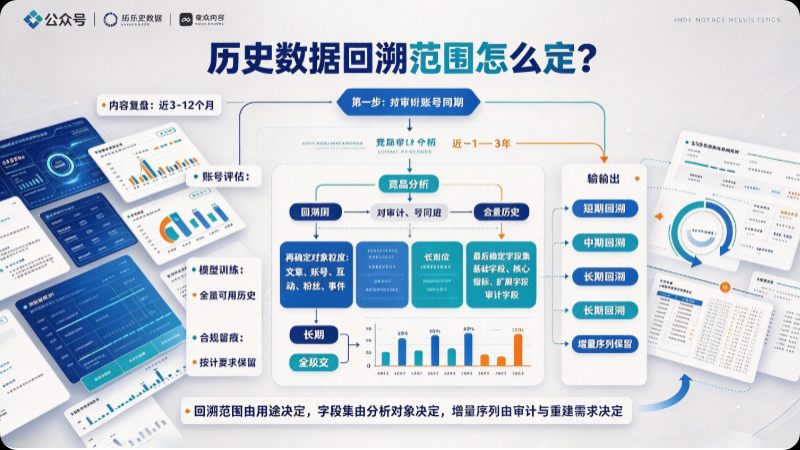
核心判断:回溯深度由“账号在决策中的角色”决定,不由“能不能拉”决定
一次性把 50 个账号的 24 个月数据全部拉满,在技术上可能可行,在工程上不划算:存储成本、清洗复杂度和去重难度会同步上升,而其中相当一部分账号你永远不会做深度分析。更务实的做法是先给每个账号分配一个角色,再按角色决定回溯深度。
| 账号角色 | 回溯深度 | 保留形态 | 典型用途 |
|---|---|---|---|
| 核心竞品(3–5 个) | 12–24 个月 | 全字段 + 多时间窗口增量序列 | 建立内容基线、年度趋势对比、选题类型分析 |
| 观察名单(5–10 个) | 3–6 个月 | 核心字段 + 发文后 1/3/7 天三个切面 | 判断是否值得升级为核心竞品,初步了解内容节奏 |
| 一次性研究目标 | 按研究需要指定区间 | 核心字段快照,用完归档 | 特定选题的横向对比、行业扫描 |
这个分层不是为了“省成本”而妥协,而是为了让核心竞品的数据保留足够精细。把资源集中在少数真正影响决策的账号上,比在几十个账号上保留浅层数据更有分析价值。
关键增量:历史数据保留“增量序列”,而不是“最终快照”
推荐时代的一篇文章,阅读量可能在发文后第 3 天甚至第 7 天发生显著变化。如果历史回溯只保留“拉取那一刻”的阅读总量,你无法回答一个对选题判断至关重要的问题:这篇文章的长尾增量占总阅读的比例是多少?
支柱页已经指出,长尾信号是推荐时代竞品追踪和自身复盘的核心指标之一。但要让这个指标在历史数据上可用,保留方式必须从“快照”升级为“序列”。具体做法不复杂:对核心竞品的每一篇文章,保留至少三个时间切片的阅读量——发文后 24 小时(或最近可得的首日值)、第 3 天、第 7 天。如果历史数据在拉取时已经错过了这些时间点,至少保留“当前总量”和“可推断的首日基线”(如果数据源提供历史增量字段),并在后续监测中对新发文章严格执行三切片保留。
一个更完整的做法是保留日增量序列:每篇文章一行,列为文章 ID、发布日期,以及发文后第 1 天到第 N 天的每日增量。这个结构比“总量快照”多占的存储空间有限,但它让“长尾占比”“推荐二次放量的时间分布”“不同类型内容的长尾强度差异”这些分析成为可能。没有这个序列,历史回溯就只是“把旧文章拉下来看了一眼”,而不是“建立了一套可以反复挖掘的内容基线”。入库前先过一遍【API 数据质量验收清单】。
回溯深度不等于回溯精度的另一个维度:字段的历史覆盖
不同字段在历史数据中的可得性不同。阅读量、点赞、在看等核心互动字段通常覆盖较好,但来源结构(推荐占比等)和完读率字段在历史数据中往往不可得或覆盖不完整。这意味着对历史文章做“推荐依赖度”分析时,需要接受一个现实:来源结构可能只能从某个时间点之后才开始有可用数据。在做回溯规划时,先确认目标字段的历史覆盖起点,再决定用多长时间窗口做哪类分析——不要设计一个依赖 24 个月来源结构数据、但实际上只有 6 个月可用的分析方案。
可带走的工具:给现有竞品名单做一次角色标注(核心 / 观察 / 一次性),按角色匹配回溯深度。对核心竞品,检查现有数据是否保留了多时间切片;如果没有,从下一批新发文章开始执行三切片保留,历史文章用“当前总量 + 可推断的首日值”做降级处理。角色分层和增量序列的完整逻辑,见【回到公众号数据分析系统方法的支柱页】。