不同背景的人如何批量采集搜一搜下拉词
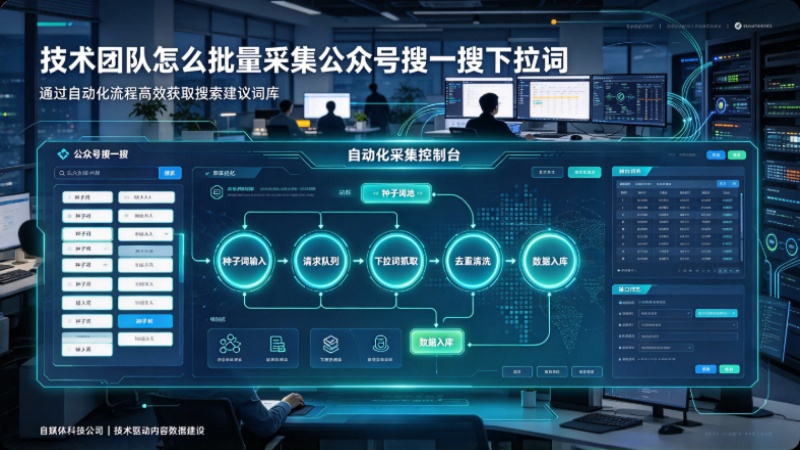
很多公众号运营者都经历过这样的困境:明明知道搜一搜是重要的流量入口,也知道下拉词背后藏着用户的真实需求,但一到“怎么批量采下来”这一步就卡住了。手动采集的极限是每天几十个词——在微信搜一搜输入种子词、不点搜索、长按复制下拉词,一条条翻阅效率极低。而真正要做系统化的关键词布局,需要的是几百甚至上千个词。
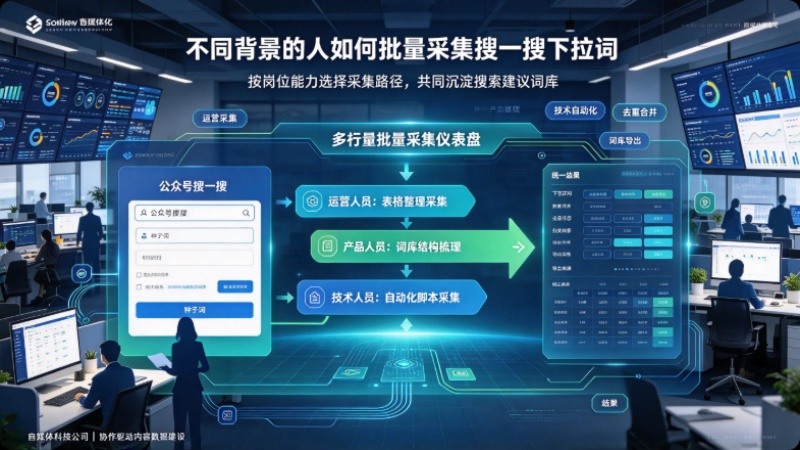
问题在于,不同技术背景的人,需要的方法完全不同。不懂技术的运营人员、有自动化经验的团队、有开发能力的工程师,各自能找到的“最优解”差异很大。这篇文章就是帮你找到适合自己的那一种。
方案一:飞书插件——零代码,日常运营首选
适合人群:不懂技术、但需要日常采集下拉词的运营人员。
核心痛点是:没有技术团队支持,也不想学代码,但每天都要用到下拉词来做选题。
操作方式很简单。在飞书中安装“多平台数据采集助手”插件,输入种子关键词,下拉词数据就会自动写入多维表格,并且可以设置定时任务自动更新,从头到尾不需要写一行代码。运营人员每天早上打开飞书,就能看到最新的下拉词列表,直接用于当天的选题。
这个方案的定位非常清晰:适合日常几十个关键词的常规采集。插件由第三方维护,页面结构变化、接口调整都不需要运营人员操心。批量能力有限,但“打开就能用”这一点,对没有技术背景的人来说是最重要的。
一个做本地母婴号的运营者,之前每天花半小时手动截图下拉词。换成飞书插件后,她把“宝宝辅食”“婴儿睡眠”等10个核心词设成定时采集,每天早上打开表格就能看到最新词列表,选题时间从半小时压缩到五分钟。
方案二:RPA机器人——批量采集的自动化方案
适合人群:有一定工具使用经验、需要批量采集几百个关键词的运营团队。
核心痛点是:飞书插件适合日常几十个词,但到了几百个词的量级,手动配置和等待就成了瓶颈。
RPA机器人的工作原理是模拟人工操作:把关键词整理到Excel中,机器人自动打开微信搜一搜,逐个搜索关键词并获取下拉框中的下拉词,结果导出为Excel。5118的机器人需要准备Chrome浏览器并安装影刀扩展程序,在输入表填写搜索词,运行后结果自动保存至输出表。八爪鱼的操作类似:导入关键词Excel,选择结果存放目录,点击运行即可。
RPA方案的核心优势是不会触发微信风控——机器人完全模拟人工点击和输入,跟真人操作一样。但批量能力也有上限,适合百级关键词的周期性采集,不适合高频、大规模的场景。以八爪鱼RPA为例,导入20个搜索词,1分钟多即可获得178个下拉词数据。
有一个做职场内容的运营者,需要每周采集500个关键词的下拉词。之前用飞书插件,每天手动配置要花一个多小时。后来切换到5118的RPA机器人,把关键词整理进Excel,一键运行自动跑完,采集时间压缩到10分钟以内。
方案三:API接口——技术团队的规模化方案
适合人群:有开发能力的团队,追求稳定、可批量、可集成到现有系统。
核心痛点是:前两种方案的数据输出是表格,无法直接对接内部的选题库或BI系统,数据字段也不够完整。
API方案解决的就是这个问题。注册获取API Key后,调用搜一搜实时搜索接口,传入种子关键词,返回结构化的JSON数据,包含下拉词列表和对应的搜索结果。极致了数据的公众号API覆盖50个数据方向,搜一搜实时搜索是其中一项核心能力。
API方案的优势有三个。第一是并发效率:支持五路并发采集,二十个关键词几秒钟跑完,新发布的文章被收录的时间差仅10到30分钟。第二是数据字段完整:不仅能获取下拉词,还能批量查询文章库,返回标题、阅读量、点赞数、在看数等完整字段,支持近5年历史推文回溯。微信官方后台只保留30天数据,API弥补了这个缺失。第三是可集成性:JSON数据可以直接对接选题库、BI系统或运营中台,技术团队一两天就可以跑通。
一个典型案例是某电商团队用API将下拉词采集嵌入内容系统后,运营人员在系统里看到的不是原始词列表,而是按搜索热度和竞争程度排序的推荐选题。蓝海词自动标蓝、红海词自动标红,整个流程从“凭感觉写”变成“看数据写”,搜一搜入口的自然流量有了明显提升,复购率也随之提高。
方案四:AI工具辅助——轻量补充方案
适合人群:想快速获取灵感、不想搭建系统的轻量用户。
Kimi联网后可以实时抓取微信搜一搜的下拉词和关联问题,通过分步指令模拟用户搜索行为。操作方式是在Kimi中依次输入指令,比如“微信搜一搜输入‘显瘦西装裤’,关联度最高的3个长尾问题词是哪些”,Kimi会返回结构化结果。
这种方式的优点是不需要安装任何工具,缺点是批量能力和结构化程度有限,适合极小批量、临时性的需求。另外还有一种更低门槛的方式:在微信搜一搜截图“相关搜索”区域,上传到AI工具的图片识字功能,识别出长尾词列表。适合完全没有工具基础的运营新手做初步探索。
怎么选:四种方案对比
| 对比维度 | 飞书插件 | RPA机器人 | API接口 | AI工具 |
|---|---|---|---|---|
| 技术门槛 | 零代码 | 零代码 | 需开发 | 零代码 |
| 批量能力 | 日常几十个 | 百级关键词 | 高,支持并发 | 少量 |
| 数据输出 | 多维表格 | Excel | JSON结构化 | 文本列表 |
| 维护成本 | 低(第三方维护) | 中(需配置环境) | 中(需对接维护) | 极低 |
| 适合场景 | 日常运营采集 | 批量周期性采集 | 规模化/系统集成 | 临时灵感获取 |
一句话选型建议:不懂技术就用飞书插件,需要批量就用RPA,有开发团队就上API,临时探索用AI工具。
结语
下拉词的价值已经被反复验证:68%的用户在输入2到3个字后就会选用下拉框推荐的词,点击率是普通关键词的3到5倍。但这些流量不会自动流向你——它需要有人把下拉词从搜索框里提取出来,变成可以批量处理、结构化保存的数据。
方法层的问题不是“有没有工具”,而是“哪个工具适合我的技术背景和采集量”。飞书插件解决日常,RPA解决批量,API解决规模化,AI工具解决临时性。选对了工具,采集这件事就从“手动一条条翻”变成了“打开表格就能用”。