公众号一二级评论明细采集方法
公众号评论区是用户真实声音的聚集地——有人抱怨问题,有人分享方案,有人提出质疑,有人补充细节。如果你想研究用户需求、整理痛点、分析讨论趋势,评论区就是现成的素材库。但评论区虽然信息量大,却很难系统化地整理。折叠回复要一条条手动展开,几百条评论翻下来,光复制粘贴就得花半天。
要把公众号评论明细采集下来,有三道关键的坎需要跨过,每一道都对应着不同的技术挑战。
第一道坎:二级评论的采集深度
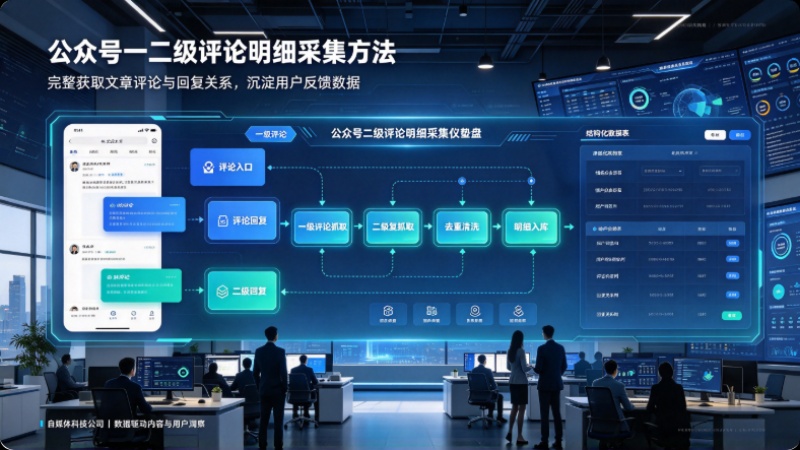
公众号评论区分为两个层级:一级评论是读者对文章的原始留言,二级评论则是读者之间的互相回复,即所谓的“楼中楼”。后台只能逐条点击才能看到二级评论的全部内容。
二级评论的采集远比想象中复杂。折叠形态层次繁多,包含“X条回复”子回复、“更多回复”、子回复内部二次折叠,还有作者回复的特殊标识。折叠按钮不会一次性全部加载,还会出现被遮挡、不在可视区域导致点击落空的情况。换言之,采集工具必须模拟人工操作:先滚动到评论区,持续点击展开所有折叠回复,循环往复直到页面底部。
RPA开发者“掌心向暖”在实际开发中发现,公众号没有独立网页端,只能在PC客户端操作。PC微信不能直接抓取评论元素,需要依靠遍历控件树识别每条评论,依靠横向缩进区分评论层级关系——哪条是主评论,哪条是回复,从属关系是什么。如果只采集一级评论,你得到的是零散文本;采集完整的一二级评论,拿到手的是一棵完整的“讨论树”,在哪里有人回复了什么、哪个观点引发了争论、一条负面评价下面有多少人附和,一目了然。
第二道坎:字段粒度的精度问题
采集字段的颗粒度,直接决定了数据后续能用来做什么。不同技术路线的输出差异很大。
RPA类方案通常可采集9个字段,包括昵称、IP地址、评论日期、评论内容、点赞数等,导出xlsx表格和层级化Markdown两份文件。这套字段组合足以支撑运营层面的筛选和排序。
API类方案在字段设计上更精细。以Apify平台的微信公众号采集器为例,其输出schema中明确区分了_contentId(父评论ID)和_replyIndex(回复在父评论中的位置),可以精确还原每条回复的从属关系。TikHub的API文档则揭示了另一个关键的技术细节:content_id和reply_id等标识为64位大整数,超出JavaScript安全整数范围(2^53-1),必须以字符串方式接收和传递,否则会出现末位精度丢失。这个细节看似微小,但在大规模数据采集中,一个精度丢失的ID就意味着一条回复关系的断裂。
第三道坎:覆盖度的预期管理
这是采集工作中最容易被忽视、也最容易导致需求偏差的问题:文章顶部显示的留言总数,与实际可采集到的数量往往存在显著差距。
RPA开发者“掌心向暖”在实际开发中发现,“文章顶部显示的留言总数,和实际能加载出来的数量经常对不上”。原因在于:留言总数统计的是所有留言——精选的、普通的、被折叠的、被限流的都算在内。但评论区实际显示什么,受平台展示策略、审核状态、折叠规则的多重影响。最终能采集到的,是滚动触发加载出来的那部分。
这意味着在设定采集需求时,必须明确对覆盖度的预期。如果期望的是文章发布后的全部用户留言,那无论技术方案如何设计都无法满足,因为未被精选的留言在公开层面根本不可见。接受“以实际可加载为准”的边界,技术方案的选择才会更有针对性。
三条技术路线怎么选
目前公众号评论采集主要有三条路线。
API接口方案适合有技术团队的企业。核心流程是先用文章URL调用一级评论接口获取评论列表,再以每条评论的content_id为参数调用二级回复接口获取该评论下的所有回复。技术人员对接接口一般在一两天内可以完成,接口响应时间在1至3秒之间,支持并发调用。
RPA自动化方案适合无编程能力的运营人员。通过影刀等RPA工具模拟人工操作PC微信客户端,自动滚动评论区、点击展开折叠回复,最终导出xlsx和层级化Markdown两份文件。使用时建议拿小号测试,控制好采集频率。
开源工具方案适合有自部署能力的技术用户。wechat-article-exporter支持导出评论和评论回复,需要抓包获取credentials信息,支持docker私有化部署。
无论选择哪条路线,理解采集深度、字段粒度和覆盖度边界这三层需求,才能在实际操作中做出合理的判断。