公众号一二级评论评论采集的应用场景
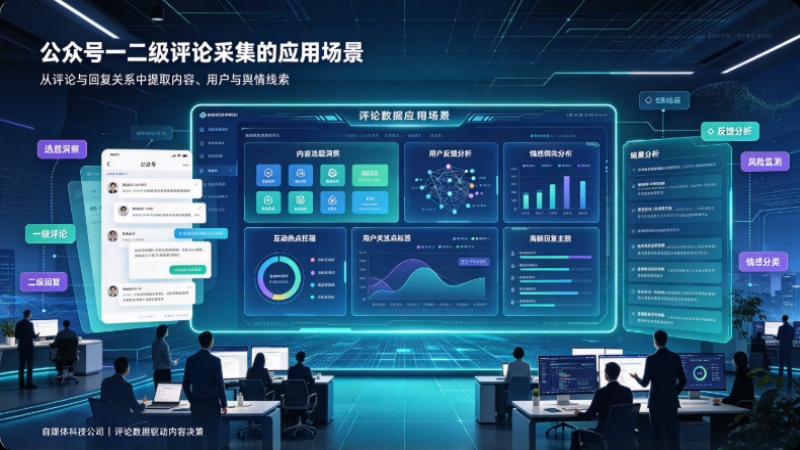
很多人想做公众号评论采集,往往是从一个非常具体的念头开始的。有人是运营,想看看自己文章的读者到底在说什么;有人是做品牌的,想知道竞品评论区里有没有用户在吐槽什么;有人是研究员,想拿评论数据做分析。出发点不同,对采集结果的要求就完全不同。同样叫“采集公众号评论”,有人只需要几百条文本做个情绪判断,有人则需要完整的讨论树和精确到每条回复的从属关系。换句话说,场景决定了需求,需求决定了采集方案怎么搭。
围绕几个典型应用场景,看看不同的实际需求会导致采集方案出现多大差异。
场景一:品牌舆情监控——要快、要准、要能告警
品牌舆情监控是最常见也最紧迫的采集需求。公众号评论区一旦出现负面集中讨论,扩散速度极快,留给品牌方反应的时间窗口非常短。某快消品牌监测到竞品在公众号评论区出现“产品质量问题”的集中讨论后,提前72小时启动公关预案,有效规避了舆情扩散。72小时的提前量,靠人工翻评论区是绝对做不到的。
这个场景对采集的核心要求是时效性和敏感词识别。采集频率需要支持分钟级轮询,关键变化(新增评论量突增、负面词频飙升)要能设置阈值自动告警。负面的信号往往藏在二级评论里——某条一级评论看起来只是一个用户抱怨,但底下跟了十几条“我也是”“太坑了”的回复,这已经是明确的扩散信号。如果采集方案只看一级评论,这类信号就完全被漏掉了。
品牌舆情监控对字段的要求相对聚焦:评论文本、时间戳、点赞数是核心,一级评论和二级评论都需要覆盖,但不需要做深度的用户画像分析。采集方案的侧重点是响应速度,舆情监控工具需要做到分钟级轮询。另一个值得注意的痛点是,有些品牌舆情监控只覆盖了自己的公众号,而竞品评论区的讨论同样值得关注——竞品读者的抱怨往往就是自家产品的机会信号。
场景二:用户需求研究——要全、要深、要能画出讨论树
用户需求研究和舆情监控几乎是两个极端。舆情监控追求快,用户研究追求全。研究者需要的不只是评论文本,而是完整的讨论脉络——哪条评论引发最多讨论,哪些用户之间存在观点交锋,一条负面评论引发了多大的连锁反应。
这个场景对采集深度要求最高。以“深圳卫健委”公众号为例,评论区里“有求医问药的、信访投诉的、插科打诨的,也有参加活动的”,大量留言提供了即时用户反馈,让用户画像越发精准。如果只采集被精选的一级评论,那这些留言中大量的讨论线索就丢失了。运营团队需要看到的是:某个用户问了一个健康问题,底下有人回复了自己的类似经历,又有人补充了就医建议——这条二级评论的链条才是真正有价值的需求信号。
用户研究还有一个容易被忽视的痛点:评论用户的持续性追踪。关注经常留言的用户ID,观察其留言习惯、互动偏好、甚至在其他文章下的评论,可以构建更完整的用户画像片段。这要求采集方案不仅能做单篇文章的快照,还要支持跨文章的批量采集和用户维度的聚合。有些团队在发现深度技术解析类文章的留言用户多为资深从业者后,据此策划了更多该领域的进阶选题,这正是评论数据驱动内容策略的典型案例。
场景三:内容选题分析——要快筛、要提词、要能找“故事”
内容选题分析对采集精度的要求不高,但对数据加工的敏捷度要求很高。运营者需要从评论区快速找到高频痛点词和有画面感的故事。有经验的运营者总结出了一套方法:先画“高频词地图”,翻最近20条留言,找出出现超过3次的词,比如“不给钱”“不带娃”“老伴不说话”,这些词就是选题方向;再找“有画面的故事”,字数超过30字、有具体细节、情绪强烈的评论最有价值。
央视网“小央画话”栏目在选题与评论互动上形成了良性循环。栏目的内容往往聚焦读者关心、想看、爱聊的话题,结尾常用引导式提问邀请读者参与评论区互动。内容发出后5分钟内放出评论,选一条认真或有趣的留言做回复,让其他读者知道认真说话可以被看到。春节期间发布的《怕蛇的人怎么过蛇年?》一文,栏目专门设计了一个评论互动,评论区点赞最高的读者将收到作者手绘的“小蛇‘丑’图”——这个轻松的引子打破了读者开口的心理门槛,让评论区自然“热”了起来。
这个场景对采集的时效性要求其实不低——需要在文章发布后尽快获取评论数据,因为选题的窗口期很短。但对采集深度的要求相对宽松,一级评论就够用了。运营者不需要完整的讨论树,只需要快速扫描评论内容、识别高频词和优质故事。真正的痛点在于,几百条评论手动翻看效率太低,需要工具能快速导出数据并支持关键词筛选。
场景四:竞品评论区挖掘——要对比、要标签、要抓竞品提及
竞品评论区挖掘和品牌舆情监控有交集,但侧重不同。舆情监控看的是“自己有没有危险”,竞品挖掘看的是“对手有什么弱点”。竞品读者普遍吐槽什么功能缺失,评论区出现了哪些竞品名称,高活跃用户的身份标签分布——这些信息比正式的市场调研报告更及时、更真实。
Apify平台的微信公众号评论分析工具直接面向这个场景做了设计,其输入schema中明确支持输入竞品品牌或产品名称,自动识别并比较评论中的竞品提及,同时提取高频读者问题、需求信号和购买意向。这意味着运营者不需要手动一条条翻竞品评论区,工具会自动标注出“用户抱怨了A产品”“有人在问B品牌有没有类似功能”这类信息。
这个场景的痛点是竞品对比的维度设计。如果只是把竞品评论和自己的评论分别采集下来,那只是两份数据,不是洞察。真正有价值的是跨账号的对比分析——同一类话题下,竞品读者和自家读者的情绪倾向有什么不同;竞品评论区的高频负面词是否正在成为自家产品的卖点机会。这些分析对采集字段的要求比较高,除了基础的评论文本,还需要品牌提及标签、情感倾向标签、用户身份标签等结构化输出。
场景五:政务与学术研究——要合规、要批量、要长周期
政务公众号的评论区承担着一项特殊功能:民意收集。“深圳卫健委”评论区里,市民留言涉及求医问药、信访投诉等民生诉求,大量留言提供了即时的用户反馈。上海虹口区融媒体中心则更进一步,开发了全平台留言收集系统,统一归集抖音、微博、APP等多平台的市民留言,实现民意诉求的统一管理、统一回应,将公众号评论从“留言板”升级为“民意通道”。
政务场景对采集的核心诉求是归集与闭环。临沂市的“12345临沂首发”平台出台了群众留言评论收集应用机制,形成了“融媒互动—热线转交—部门应用—融媒跟进”的工作闭环。这意味着采集不是终点,采集到的诉求需要流转到对应的职能部门去处理。这个场景的采集方案需要与政务系统对接,对数据格式的规范性和可追溯性要求高于一般分析场景。
学术研究场景则更关注数据的可重复性和历史覆盖。有研究者使用Python开发了自动采集公众号文章及用户评论的系统,用于掌握公众对特定话题的关注和情绪动向。学术场景往往需要跨年度的批量采集,对字段的完整性和一致性要求非常高。有技术社区的用户整理了某心理学公众号2019至2024年全部历史文章的评论数据,包含文章标题、发布时间、评论ID、评论内容、点赞数、作者回复内容等字段,用于特定话题的长期趋势分析。
这个场景最大的痛点是合规边界。微信服务协议明确禁止第三方自动化抓取公众号内容,2021年杭州互联网法院曾判决某公司因爬取微信公众平台数据赔偿60万元。政务和学术场景虽然目的正当,但在采集方法上仍然需要格外注意合规性,建议优先考虑通过官方渠道或获得授权的方式获取数据。
需求细分总结表
| 需求维度 | 品牌舆情监控 | 用户需求研究 | 内容选题分析 | 竞品评论区挖掘 | 政务/学术研究 |
|---|---|---|---|---|---|
| 评论层级 | 一二级均需 | 一二级完整讨论树 | 一级为主 | 一二级均需 | 一二级完整 |
| 核心字段 | 文本、时间、点赞 | 文本、用户ID、回复关系 | 文本、点赞、时间 | 文本、品牌提及、情感标签 | 文本、ID、时间戳 |
| 覆盖度预期 | 实时增量 | 尽可能全量 | 近期评论即可 | 竞品全量 | 长周期历史数据 |
| 时效性 | 分钟级 | 按需 | 文章发布后快速 | 每日/每周 | 批量历史 |
| 采集频率 | 1-10分钟轮询 | 按需触发 | 发布后24小时内 | 每日轮询 | 一次性批量 |
| 合规优先级 | 中 | 中 | 低 | 高(竞品数据边界) | 高(学术伦理) |
| 典型输出 | 告警+趋势图 | 讨论树+用户画像 | 高频词+故事素材 | 竞品对比报告 | 结构化数据集 |
结语
公众号评论采集没有“万能方案”,不同的应用场景对采集深度、字段粒度、时效性和合规性的要求差异巨大。做舆情监控的人不需要完整的讨论树,但需要分钟级的响应速度;做用户研究的人不追求实时,但需要精确到每条回复的从属关系;做选题分析的人可以接受只有一级评论,但需要快速筛选和关键词提取。先想清楚你要解决什么问题,再去选择对应的采集方案,才能让评论区真正变成有价值的数据资产,而不是一堆采集下来就再也没打开过的表格。