公众号竞品发了什么,怎么看
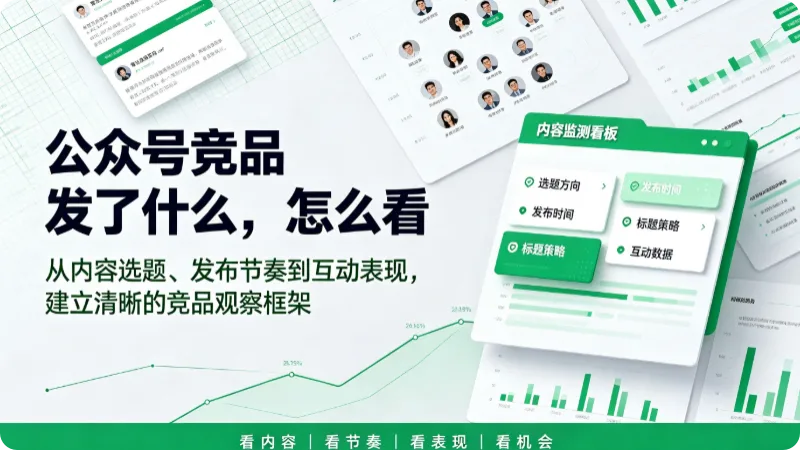
你不需要“看”竞品发了什么,你需要一张把竞品过去一段时间所有文章摆在一起的结构化表。 手动翻历史消息能看见标题,但看不见发文节奏和互动数据的对应关系,而竞品分析真正要回答的问题,恰恰藏在节奏和数据的关系里。
先别急着看内容,先把“看什么”定下来
竞品分析最容易犯的错,是把“看竞品发了什么”等同于“读竞品的文章”。读文章是内容消费,不是数据分析。
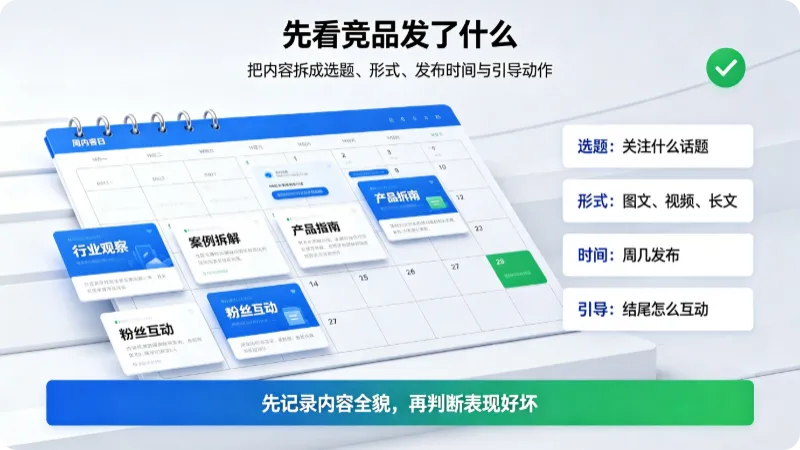
真正要盯住的是四个东西:发文频率有没有变化、同一选题方向被触碰了几次、每次触碰的阅读量走势、以及发文时间与互动峰值之间的对应关系。一个选题如果竞品每隔几个月做一次、每次阅读量都稳定在自身均值以上,说明它是被验证过的底盘;如果第二次做同选题时阅读量明显衰减,说明竞品自己也在消耗这个方向。
判断这件事需要“多篇 × 多时间点”的对照。手动翻看能提供素材,但提供不了对照结构。
手动翻看的天花板不在“翻”,在“只能翻到最近的”
公众号官方后台只保留近30天的互动数据,超过30天的文章,阅读量、点赞、在看全部清空。这意味着手动翻看天然被锁在一个短期窗口里。
更隐蔽的问题是边际成本。盯2个竞品、看30天,手动还能应付。盯5个竞品、回看半年,翻找和记录的时间会吃掉分析的全部耐心。有运营者算过一笔账:整理一个公众号大约30分钟,12个公众号就是6小时,三个月就是18小时——两个工作日耗在复制粘贴上。
极致了数据在这个动作里的位置:把“翻”变成“拉”
极致了数据的公众号API覆盖50个数据方向,文章列表和详情返回的是结构化字段:标题、发布时间、作者、链接,阅读量、点赞、在看、分享、收藏、评论数。配置竞品公众号的biz参数之后,接口直接返回可入库的数据,不需要先截图再整理。
关键差异在历史深度:支持检索近5年全部历史推文,补上了官方后台30天窗口之外的视野。过去两三年的选题轨迹和互动表现可以拉成一张长表,而不是只盯“最近一个月”。
如果团队不写代码,飞书应用市场的“多平台数据采集助手”插件输入公众号名称即可采集到多维表格,支持定时任务自动更新。一个运营团队的实际用法是:用飞书插件监控五个竞品公众号,每天定时同步,早上花十分钟看一遍竞品动态,替代了原来每天手动刷列表的流程。
拿到表之后,判读从“比”开始
结构化数据摆开之后,判读的起点不是“哪篇阅读量最高”,而是竞品的发文频率有没有在某个时间点改变、某个选题方向被触碰的次数与阅读量之间是否呈现衰减、发文时间段调整后互动数据有没有同步位移。这些问题单看一篇文章回答不了,放在一张按时间排列的长表里,答案自己会浮出来。把竞品分析放回数据诊断的整体流程,见〖公众号数据诊断从手动到自动的完整升级路径〗。
站内已有〖公众号竞品数据分析怎么做?〗给出了四维对比框架(发文频率、头条阅读量趋势、互动率、爆款选题类型分布),〖怎么用API接口监控多个竞品公众号的推文?〗提供了从获取biz参数到API或飞书插件配置的完整操作路径。